Proxmox VE 9.2 深度教学|网络篇
前两篇已经完成 Proxmox VE 9.2 的安装和存储规划。
安装篇中,本机使用 nic1 → vmbr0 承载管理网络,管理地址为 192.168.100.168/24;两块万兆接口 nic4、nic6 则专门留给后续业务网络使用。
存储篇又完成四块 SSD 的 ZFS 存储池以及虚拟机磁盘迁移,宿主机已经具备承载实际虚拟机的条件。
接下来需要解决的就是网络。
有VMware基础的童鞋,可以参考VMware VSphere虚拟网络的深度研究
PVE 的网络配置看起来并不复杂:创建 Bond、创建 Bridge、勾选 VLAN aware,再给虚拟机选择 Bridge 即可。
但如果只记住界面怎么点,很容易把物理网卡、Bond、Bridge、VLAN 和虚拟机网卡之间的关系混在一起。
因此,本篇仍然沿用前两篇“先理解原理,再完成配置”的方式。重点不是记住几个参数,而是理解:
一个虚拟机发出的数据包,究竟怎样从虚拟网卡经过 PVE 宿主机,最终进入物理交换机。
本文最终完成下面这套网络:

本文环境
- 宿主机:Dell PowerEdge R740;
- Proxmox VE:9.2;
- 管理网卡:
nic1,1GbE; - 管理 Bridge:
vmbr0; - 管理地址:
192.168.100.168/24; - 业务网卡:
nic4、nic6,均为 10GbE; - 业务 Bond:
bond0; - Bond 模式:IEEE 802.3ad / LACP;
- 业务 Bridge:
vmbr1; - VLAN:本篇以 VLAN 105 为例;
- 虚拟机网卡:VirtIO。
需要注意,nic1、nic4、nic6 是本机经过 PVE 接口名称固定后的名称,并不等同于服务器机箱上的物理端口编号。第一篇已经完成 MAC、PCI 地址及物理端口的对应关系,不能把本机名称直接套用到其他服务器。
一、先理解 PVE 网络:从物理网卡到虚拟机到底经过了什么
Proxmox VE 并没有重新发明一套自己的网络协议栈,它主要建立在 Linux 网络机制之上。物理接口、Linux Bond、Linux Bridge、VLAN 等能力,本质上都来自 Linux。
关于上述支持,我在Linux 虚拟网络(一)-内核对象模型有更加深入的说明。
Proxmox 官方把 Linux Bridge 描述为一个软件实现的交换机:虚拟机和物理接口都可以连接到这个 Bridge 上。虚拟机通过 Bridge 接入物理网络以后,上游网络看到的仍然是各虚拟机自己的 MAC 地址。
对于本例,可以把业务网络理解为下面几层:

(一)nic4、nic6:真正连接网线的物理接口
nic4、nic6 对应服务器上的两个 10GbE 物理端口。
它们负责把服务器的数据真正送到外部交换网络。
在本例中,这两个接口本身不配置 IP 地址,而是作为 bond0 的成员接口使用。
(二)bond0:把多块物理网卡组织成一个逻辑接口
bond0 是 Linux Bond。
它可以把多块物理网卡组合成一个逻辑网络接口,根据 Bond 模式实现链路冗余、负载分担,或者两者兼顾。
本例:

也就是说,上层不再分别面对 nic4 和 nic6,而是把它们当成一个逻辑接口 bond0 使用。
(三)vmbr1:连接虚拟机的“虚拟交换机”
有了 bond0,为什么还需要 vmbr1?
因为 Bond 解决的是:
多块物理网卡怎样组成一条逻辑链路。
Bridge 解决的是:
虚拟机怎样接入这条链路。
因此可以把它们简单记成:

Proxmox 官方同样提供了“Bond 直接作为 Linux Bridge Port”的配置示例,并指出这种方式可以给 Guest 网络提供链路容错。
因此,vmbr1 不应该简单理解为“一张虚拟网卡”。
从网络角色看,它更接近一台运行在宿主机内部的软件二层交换机。
(四)Tap 与 VirtIO:虚拟机真正连接 Bridge 的位置
QEMU 虚拟机创建以后,宿主机侧通常会出现类似:
1 | tap100i0 |
这样的接口。
可以把它理解成虚拟机网卡在宿主机侧的“网线接口”。
而虚拟机内部看到的则可能是:
1 | ens18 |
或者其他名称。
如果选择 VirtIO 网卡,数据路径可以简化理解为:

如果开启了 PVE Firewall,宿主机中还可能出现额外的 firewall bridge/interface,因此实际 ip link 输出会比上图复杂;但理解主干数据路径时,仍然可以先抓住这条主线。
二、为什么本例把管理网络和业务网络分开
第一篇安装时已经建立管理网络
它负责 PVE Web、SSH 等宿主机管理流量。
第三篇再创建业务网络,专门用于虚拟机业务流量

本例没有把所有网络全部堆到 vmbr0 上,主要是为了让管理流量与虚拟机业务流量拥有清晰的链路边界。
这里要区分一个概念:
网络隔离并不等于每个网络都必须使用独立物理网卡。
常见隔离方式如下:

具体采用哪一种,应根据流量类型、带宽、故障域和安全要求决定。
本例的设计比较简单:
管理网络使用独立千兆接口;虚拟机业务使用双万兆 Bond。
这是一种适合当前单节点环境的规划,并不是说所有 PVE 环境都必须按照这种方式部署。
三、配置 Bond:为什么选择 802.3ad / LACP
PVE 支持 Linux Bond 的多种模式,例如:
- active-backup;
- balance-xor;
- balance-rr;
- 802.3ad;
- balance-tlb;
- balance-alb 等。
实际上生产环境最常见、也最值得重点理解的是:
1 | active-backup |
Proxmox 官方明确建议:如果交换机支持 IEEE 802.3ad/LACP,可以优先使用 802.3ad;如果交换机不支持,一般考虑 active-backup。
(一)active-backup
工作方式类似:
1 | nic4 ← Active |
平时主要使用一条链路,当活动链路故障后,由备用链路接管。
它的优势是结构简单,对交换机要求较低,主要解决链路冗余。
(二)802.3ad / LACP
本例采用:
1 | nic4 ─┐ |
LACP 可以把符合条件的成员接口加入同一个聚合组,通过哈希方式把不同流量分配到成员链路,同时提供成员链路故障后的容错能力。
(三)最容易产生的误解:2×10GbE 不等于单连接 20Gbps
这是理解链路聚合非常重要的一点。
本例两块 10GbE 网卡加入 LACP 后,整个聚合组确实拥有多条 10GbE 成员链路,但这并不意味着:
1 | 一个 TCP 连接 = 20Gbps |
Linux Bonding 文档说明,802.3ad 会根据 transmit hash policy 选择成员接口。以 layer2+3 为例,会结合二层和三层信息计算哈希,同一对网络端点的流量会稳定地选择某个成员接口。Linux 内核文档也明确指出,对于 802.3ad 等负载分担模式,单个连接通常不会跨越多块成员网卡获得叠加后的链路带宽。

四、LACP 不只是 PVE 端配置:交换机也必须配合
这是部署过程中最容易忽略的问题之一。
交换机侧对应的两个接口也需要加入同一个链路聚合组,并启用兼容的 LACP 配置。
逻辑关系应该类似:

具体命令取决于交换机厂商,因此本文不使用某一家交换机的 CLI 作为通用配置。
关于交换机侧的原理和部署,可以参考我之前一篇文章M-LAG
除了聚合关系,还要考虑后续 VLAN 105,因此交换机上的聚合逻辑接口还需要能够以 Trunk 方式承载相应 VLAN。
五、PVE 网络配置实战:从 Bond 到 VLAN 接入
(一)创建 bond0:完成双万兆 LACP 聚合
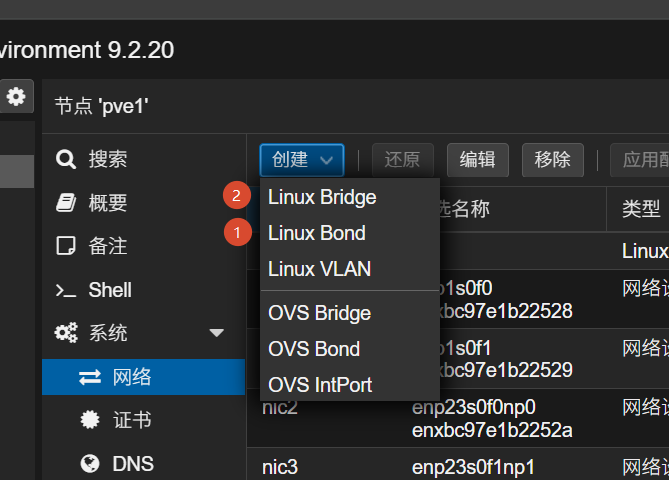
进入节点1,选择网络,选择创建Linux Bond
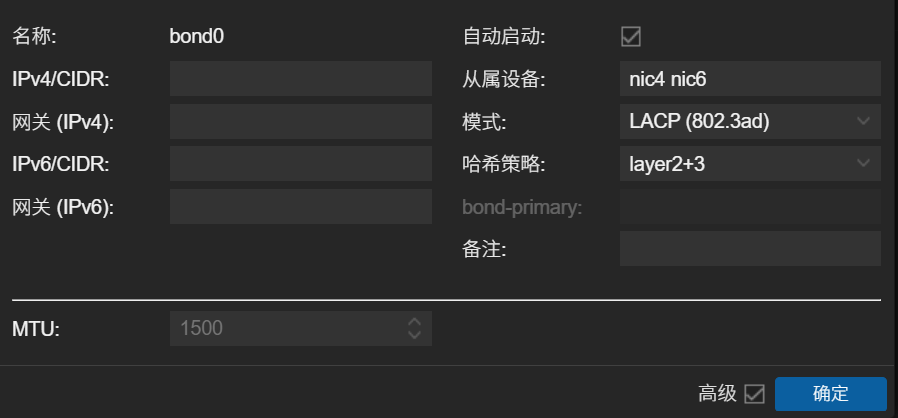
本例核心参数如下:
| 参数 | 本例 | 含义 |
|---|---|---|
| 名称 | bond0 |
Bond 逻辑接口 |
| Slaves | nic4 nic6 |
两块 10GbE 成员接口 |
| Mode | 802.3ad |
IEEE 802.3ad / LACP |
| Hash Policy | layer2+3 |
根据二层和三层信息选择发送成员 |
| IPv4/CIDR | 不配置 | Bond 本身不承担本例宿主机三层地址 |
| Gateway | 不配置 | Bond 本身不承担本例宿主机三层地址 |
通过查看/etc/network/interfaces配置文件,对应配置大致为
1 | auto bond0 |
这里的:
1 | iface bond0 inet manual |
iface bond0 inet manual 表示本例不在 bond0 这个逻辑接口上配置宿主机 IPv4 地址。bond0 仍会正常创建并工作,只是作为 vmbr1 的底层 Bridge Port,负责承载二层业务流量。
原因并不是 Bond “不能有 IP”。
PVE 官方实际上同时提供了“Bond 自己配置固定 IP”和“Bond 作为 Bridge Port”两种示例。
本例选择后者,因为:
bond0 的任务是作为 vmbr1 的底层链路,而不是作为宿主机业务网三层接口。
(二)创建 vmbr1:将 Bond 接入 Linux Bridge
创建 Bond 后,再进入:
1 | 节点 pve1 |
建立 vmbr1。
核心参数:
| 参数 | 本例 |
|---|---|
| Name | vmbr1 |
| Bridge ports | bond0 |
| IPv4/CIDR | 不配置 |
| Gateway | 不配置 |
| VLAN aware | 勾选 |
| Bridge VLANs | 根据实际策略设置 |
| STP | 默认关闭 |
| Forward Delay | 0 |
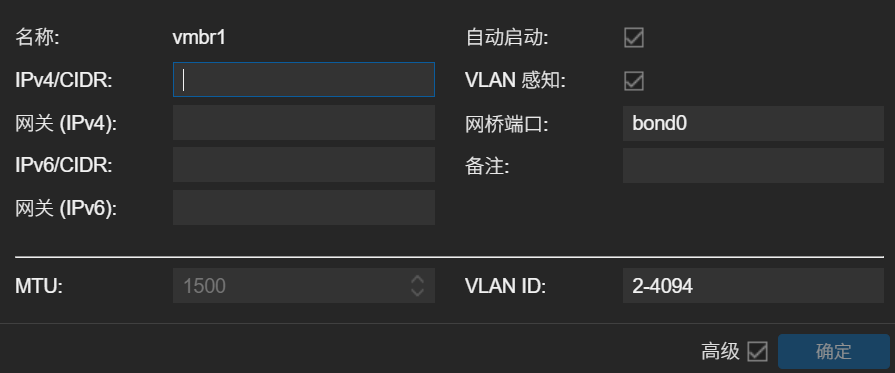
本例 vmbr1 同样不配置 IP。
原因是宿主机本身并不需要通过 vmbr1 进入 VLAN 105 的业务地址空间。
这里可以建立一个很实用的判断方法:
一个接口是否需要配置 IP,取决于宿主机自己是否需要在这一层参与三层通信。
不要因为“创建了 Bridge”就习惯性给每个 Bridge 配一个 IP。
(三) 启用 VLAN-aware:让 vmbr1 承载多个 VLAN
如果没有 VLAN,一个 Bridge 可以简单理解成一个广播域。
但生产网络中通常会存在:
1 | VLAN 105 |
如果每增加一个 VLAN,都建立一套独立接口和 Bridge,配置会越来越复杂。
PVE 支持 VLAN-aware Linux Bridge。
官方说明,使用 VLAN-aware Bridge 时,可以直接给 Guest 的虚拟网卡指定 VLAN Tag,Linux Bridge 会透明处理相应标签;相比之下,传统 VLAN 模式会为不同 VLAN 创建 VLAN Device 和对应 Bridge。
本例:

底层只需要:
1 | bond0 |
上层不同虚拟机再使用不同 VLAN Tag。
bridge-vids 应该怎么设置
官方 VLAN-aware 示例使用:
1 | bridge-vlan-aware yes |
即允许 Bridge 处理较大的 VLAN 范围。
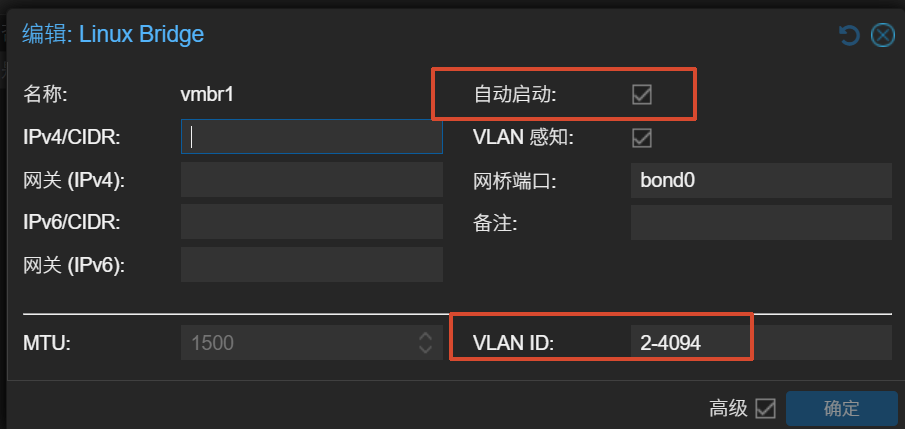
如果环境明确只需要少量 VLAN,也可以根据实际设计限制允许范围。
这两种思路分别偏向:
1 | 2-4094 |
无论 PVE Bridge 设置哪种范围,上游交换机 Trunk 也必须允许实际需要通过的 VLAN。
对于本文,至少要确保:
1 | VLAN 105 |
能够在交换机聚合链路与 vmbr1 之间完整传递。
(四) 配置虚拟机:接入 VLAN 105
完成 bond0 和 vmbr1 后,选择虚拟机:
本例配置:
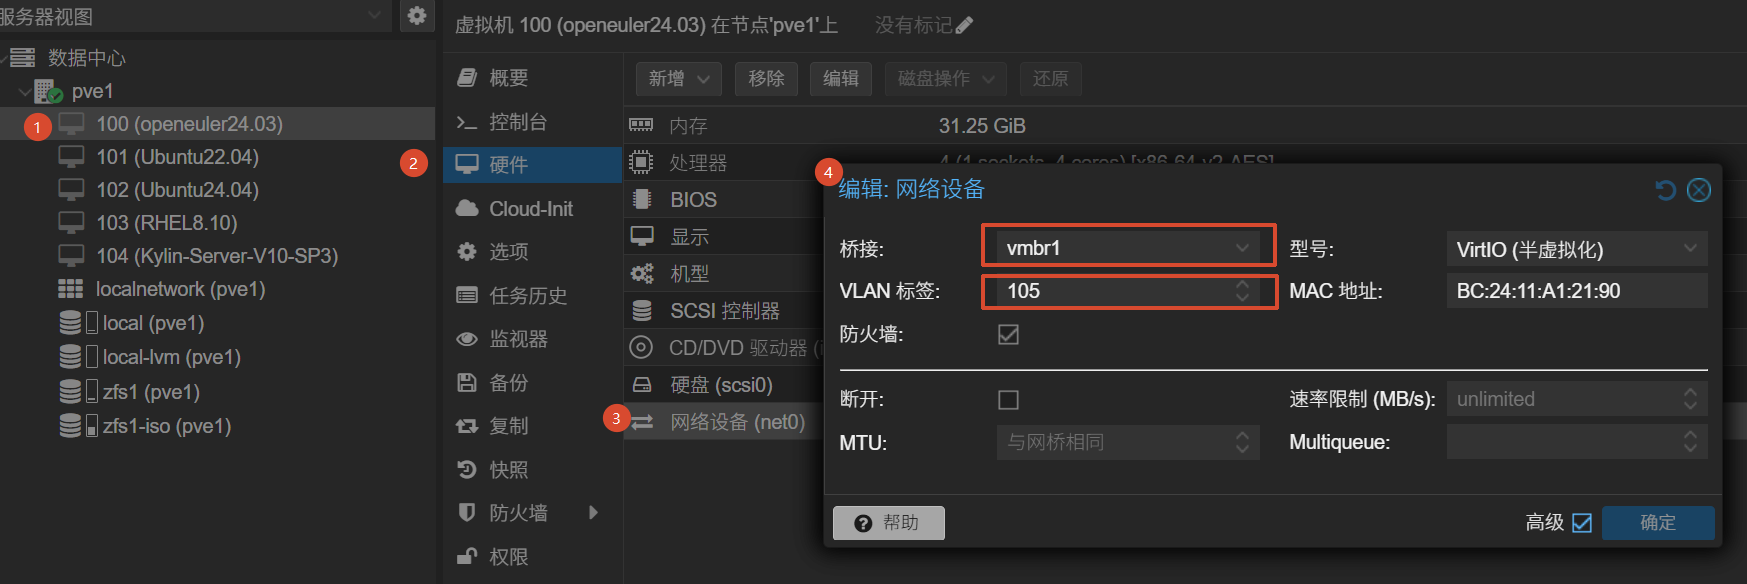
此时虚拟机不需要知道:nic4、nic6、bond0这些宿主机底层结构。
虚拟机只看到自己的 VirtIO 网卡。
从虚拟机发出的普通以太网帧,经 PVE 网络层处理后,会按照配置被归入 VLAN 105,然后经 vmbr1 → bond0 → nic4/nic6 进入物理网络。
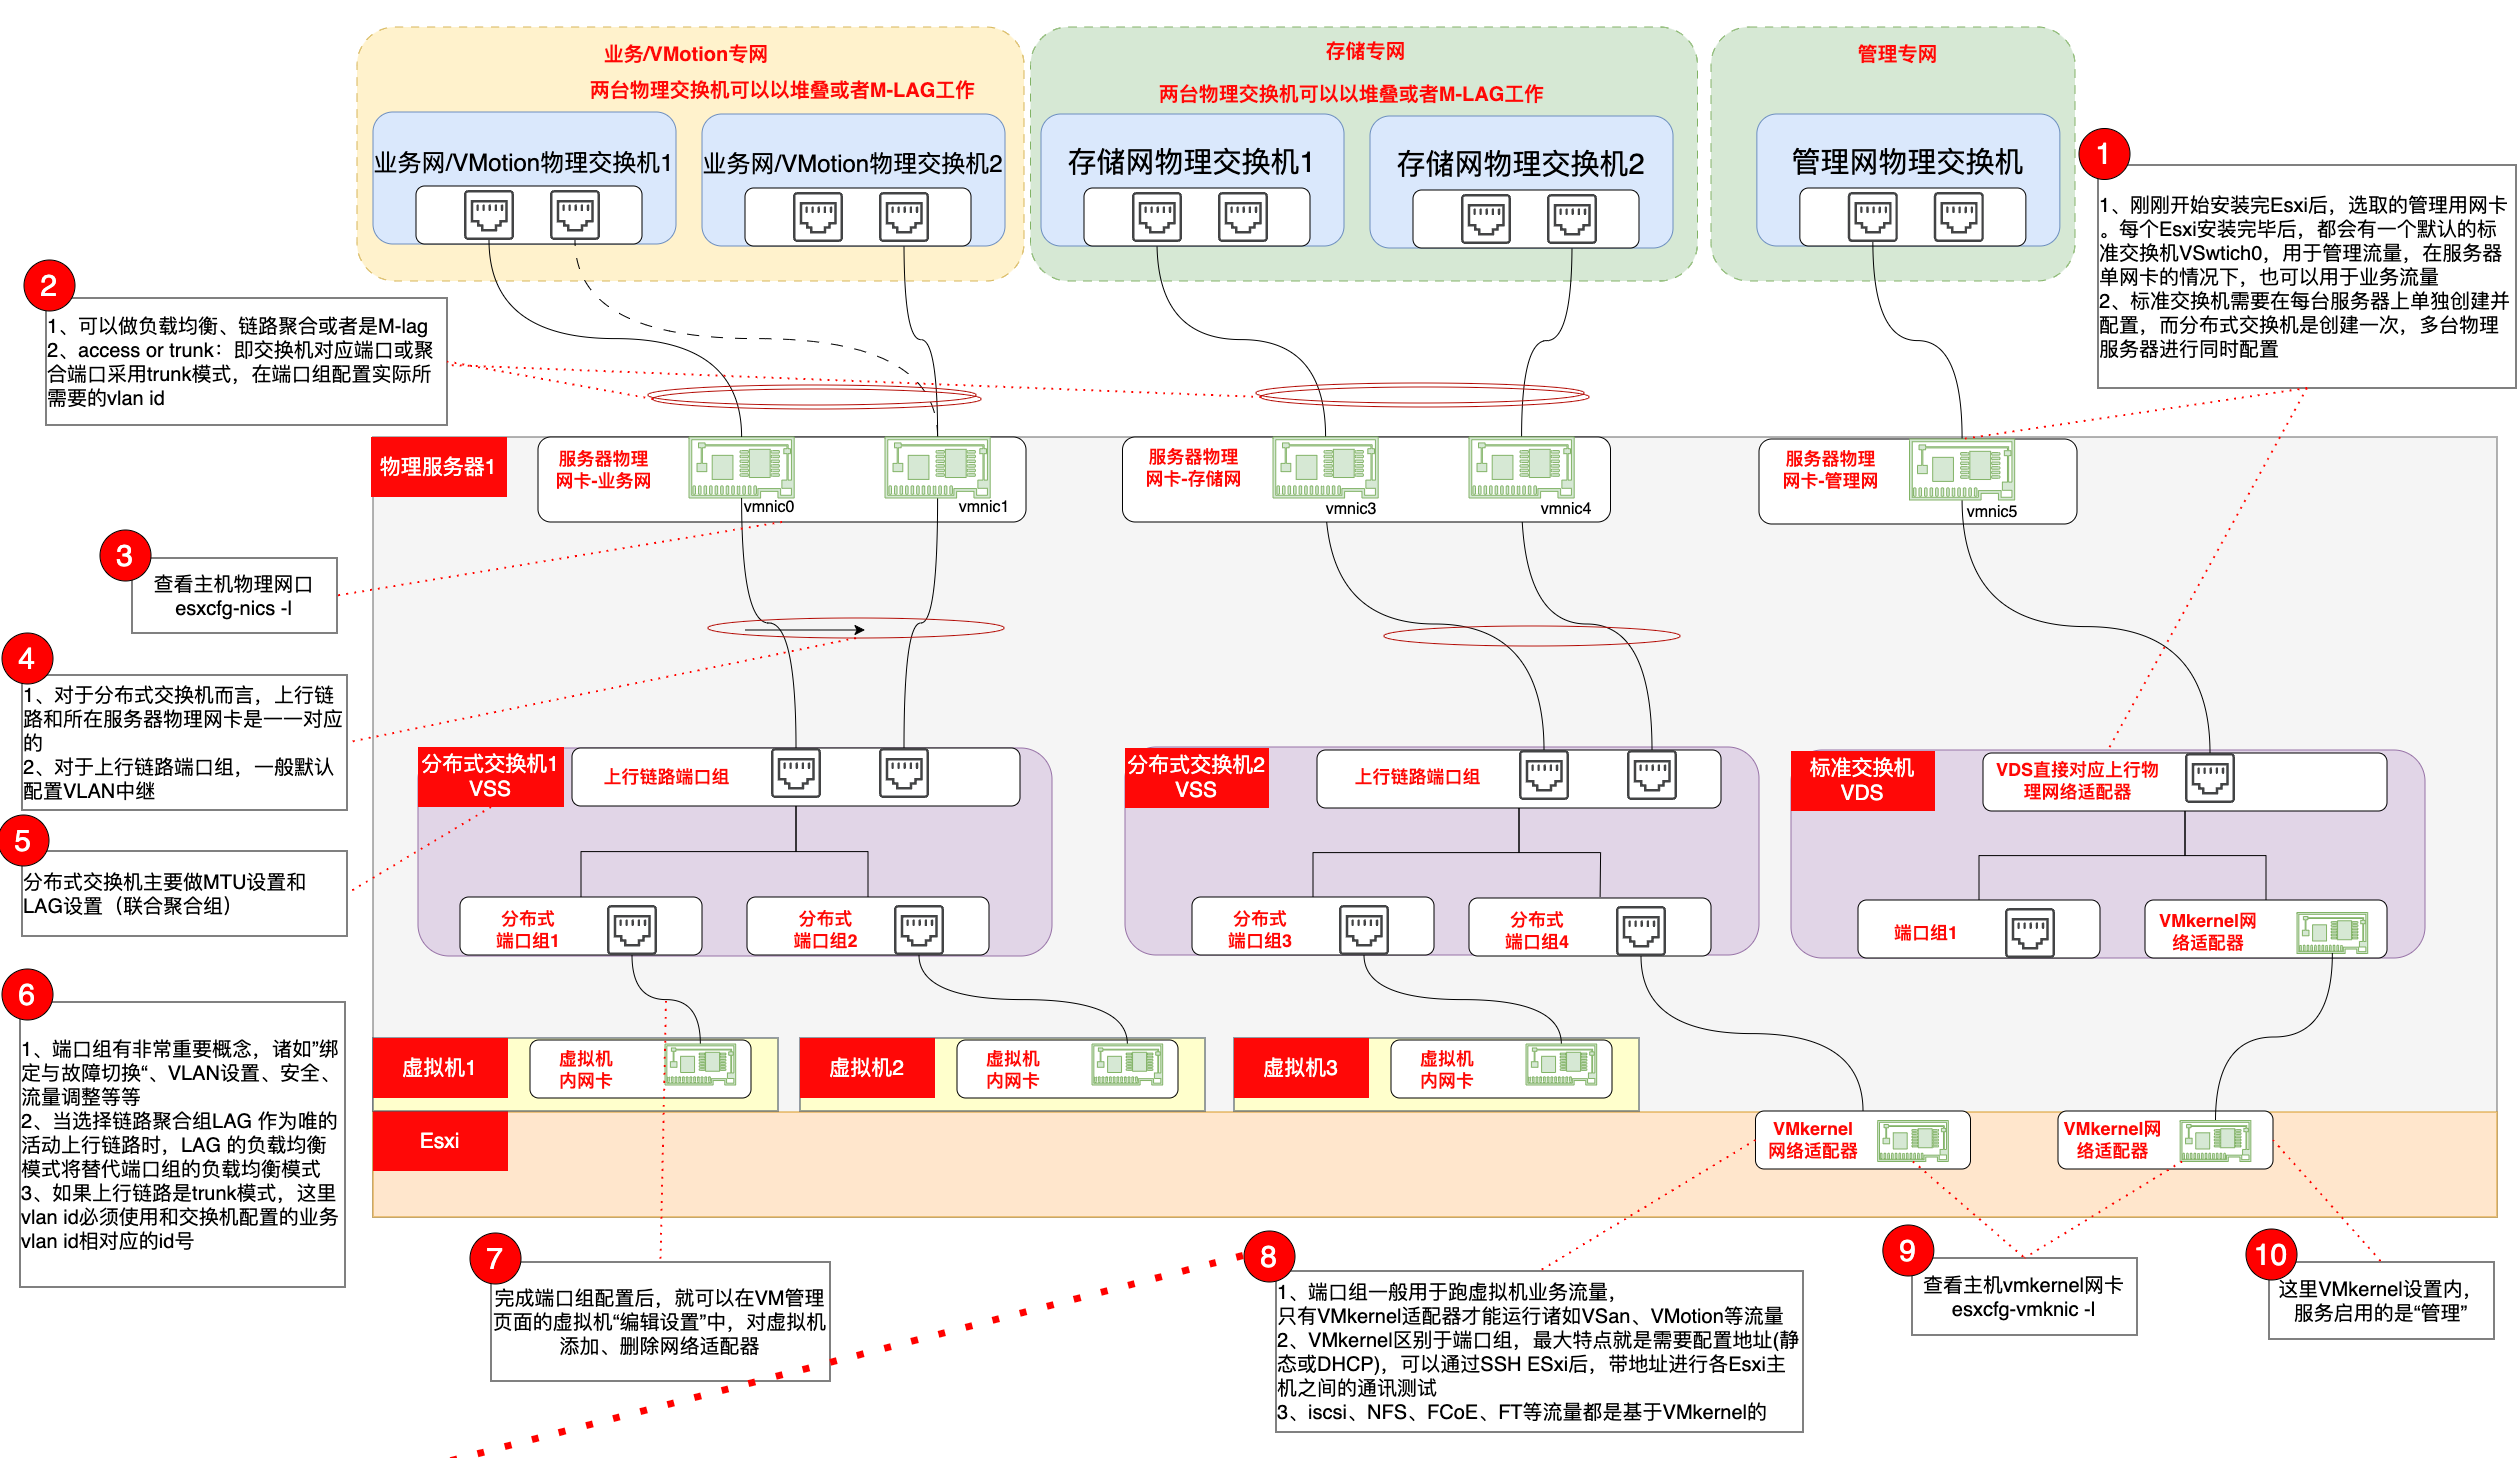
如果熟悉 VMware,可以把这里的 vmbr1 + VLAN Tag 大致类比为 VMware vSwitch + Port Group + VLAN 的接入逻辑。
需要注意,这种类比主要用于帮助理解虚拟机二层接入和 VLAN 的关系;单节点 Linux Bridge 并不等价于 VMware Distributed Switch(vDS)的跨主机集中管理机制。
可以参考我的另外一篇文章,详见VMware VSphere虚拟网络的深度研究
虚拟机内部再按照 VLAN 105 的实际地址规划配置:
1 | IP 地址 |
(五) 检查最终配置:/etc/network/interfaces
完成以上配置后,本例核心网络可以整理成下面的结构:
1 | auto lo |
从层次上看:
1 | 管理网络: |
这份配置中最值得注意的是:
1 | vmbr0 → 有 IP |
原因是:
宿主机的管理三层地址只需要存在于管理网络。
业务链路在本例中主要承担虚拟机二层转发,因此 bond0 和 vmbr1 均作为二层数据路径存在。
(六) 应用网络配置:让修改正确生效
PVE 网络配置和普通 Debian 有一个非常值得注意的地方。
通过 PVE Web 界面修改网络时,PVE 不会立即把所有修改直接写入正在使用的 /etc/network/interfaces,而是先使用:
1 | /etc/network/interfaces.new |
保存待应用配置。
完成相关修改以后,再点击:应用配置
PVE 会通过 ifupdown2 对网络配置进行重新加载。
Proxmox 官方说明,新安装的 PVE 自 7.0 起默认使用推荐的 ifupdown2;如果直接手工修改了 /etc/network/interfaces,可以执行:ifreload -a应用网络配置,而不需要为了普通网络调整直接重启节点。
官方不建议随意使用 ifdown / ifup
网络改动前为什么最好确保 iDRAC 可用
尤其是修改管理网卡、管理 IP、默认网关、Bridge Port、Bond 成员这些配置时,一旦写错就可能直接失去 SSH 和 Web 管理连接。
对于 Dell R740,本机有独立 iDRAC,因此网络结构性调整前应确认 iDRAC 控制台可以使用。
这是生产运维中的风险控制措施。
Proxmox 在重大升级文档中也长期建议,在涉及可能导致宿主机网络不可达的操作时,准备 IPMI、iKVM 或物理控制台等独立访问方式。
六、MTU 9000:万兆网络并不等于必须开启 Jumbo Frame
10GbE 网络并不意味着必须将 MTU 从默认的 1500 调整为 9000。
如果启用 Jumbo Frame,需要确保端到端转发路径中的所有相关接口和网络设备都能够承载目标报文大小,避免路径中存在 MTU 更小的瓶颈。特别是在同一二层转发路径中,应保证服务器网卡、Bond、Bridge、交换机接口及相关 VLAN 的 MTU 规划一致。
1 | MTU 1500 |
如果后续用于 Ceph、存储网络或迁移网络,再根据实际场景进行端到端测试和调整。
万兆网络决定的是链路速率,并不决定 MTU 必须使用 9000。
七、SDN 和传统 Bridge/VLAN 是什么关系
到目前为止,本例使用的是传统 Linux 网络
对于当前这台单节点 R740,这套结构已经足够清晰。
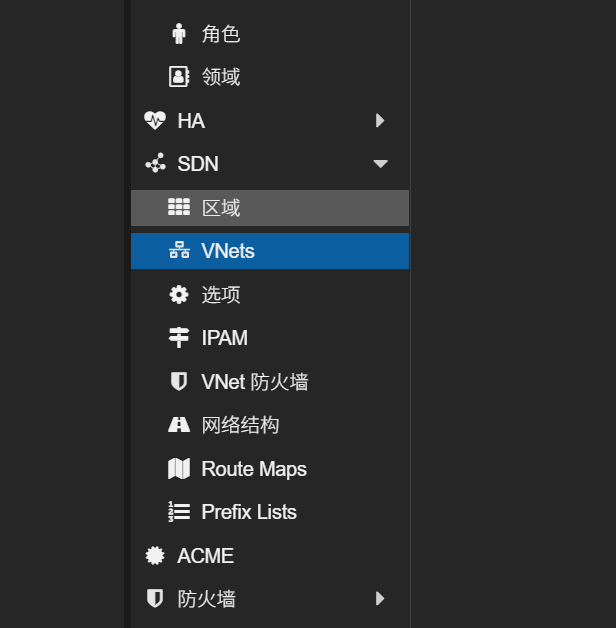
PVE 还提供 Software-Defined Network,也就是 SDN。

其中 Zone 表示一个逻辑隔离的网络区域,VNet 属于某个 Zone,Subnet 则描述 VNet 内的 IP 网络。创建 VNet 后,PVE 会在节点上提供相应的网络接口供虚拟机和容器使用。
因此:SDN 并不是普通 VLAN 的“新版替代品”。
本机采用的传统虚拟机架构反而更容易理解和维护。
Proxmox VE 9.2 于 2026 年 5 月 21 日发布,SDN 是这一版本的重点增强方向之一。
9.2 增加了 WireGuard 和 BGP Fabric 支持,并进一步增强 BGP/EVPN 的 Route Map、Prefix List 等路由控制能力。
八、PVE 网络配置中的常见误区
下面这些问题,一部分直接来自 PVE 官方文档中的 Warning、Recommendation 和工作机制,一部分属于 Linux 和交换网络的工程实践。
误区一:vmbr 是一张普通“虚拟网卡”
不准确。
vmbrX 是 Linux Bridge,更接近软件实现的二层交换机。PVE 官方也直接使用 virtual switch 来解释它。
误区二:有了 bond0,虚拟机就可以直接连 bond0,不需要 Bridge
Bond 和 Bridge 解决的问题不同。
1 | Bond |
误区三:两块 10G 做 LACP,一个 TCP 连接就是 20G
错误。
802.3ad 的流量根据哈希分配到成员接口。聚合提高的是多流并发时的总可用带宽和链路冗余,而不是保证单条连接跨两块接口获得 20Gbps。
误区四:PVE 配好 802.3ad,交换机不用配置
错误。
802.3ad/LACP 需要交换机侧支持并进行相应聚合配置。Linux 内核 Bonding 文档也将支持 IEEE 802.3ad 的交换机列为该模式的前提条件。
误区五:两根网线分别插两台交换机,就自动实现双交换机 LACP
不一定。
如果希望跨两台物理交换机组成同一个 LACP 聚合,需要交换机侧提供相应的多机链路聚合能力,例如堆叠或 MLAG 类技术。
这是交换网络设计问题,不是 PVE 自动提供的能力。
误区六:每增加一个 VLAN,都必须创建一个新的 vmbr
不一定。
PVE 的 VLAN-aware Linux Bridge 可以让多个 Guest 在同一个 Bridge 上分别指定 VLAN Tag。官方同时保留 traditional VLAN 等其他实现方式,但对于大量 Guest VLAN,VLAN-aware Bridge 往往更简洁。
误区七:每个 Bridge 都应该配置一个 IP
错误。
是否配置 IP,要看宿主机本身是否需要在对应网络进行三层通信。
本例:
1 | vmbr0 |
误区八:虚拟机配置 VLAN Tag 后,上游交换机无需管 VLAN
错误。
Guest VLAN Tag 只是完成 PVE 内部的 VLAN 分类。
对应 VLAN 仍然需要能够通过,否则数据仍然无法到达外部网络。
误区九:改完网络直接 ifdown / ifup 最方便
在普通 Linux 上可能经常这样操作,但 PVE 官方明确提醒这种方式存在 Guest 网络中断以及接口无法正确重新接入的风险。
GUI 修改优先使用:Apply Configuration/应用配置按钮
手工修改 /etc/network/interfaces 后优先使用:
1 | ifreload -a |
误区十:万兆网络就应该全部改成 MTU 9000
错误。
Jumbo Frame 是否使用取决于端到端网络设计和实际业务,而不是网卡速率。
本文首先保证网络结构正确,并保持标准 MTU。
九、生产环境中的网络实践
结合 PVE 官方文档、Linux 网络机制以及本次部署经验,可以总结出下面几条原则。
(一)先画网络关系,再创建接口
不要一上来就在 PVE Web 页面创建各种接口
先把下面关系画出来:

网络层级清楚以后,配置通常非常简单。
(二)管理链路和大流量业务要提前规划
管理、Guest、迁移、存储、备份以及未来 Corosync 的流量特性并不相同。
不一定必须全部物理隔离,但不能在没有容量和故障域评估的情况下全部堆到同一条链路。
对于未来多节点集群尤其需要注意 Corosync。
Proxmox 官方明确指出 Corosync 对延迟抖动较敏感,理想情况下运行在独立物理网络,并特别建议不要把繁忙的存储网络与 Corosync 主链路混用。
(三)LACP 两端必须统一规划
检查的不只是 PVE,还包括交换机。任何一端配置不一致,都可能形成“看起来链路是 UP,但业务异常”的情况。
(四)不要依赖临时网卡名称猜测物理端口
PVE 9 已提供网络接口名称固定机制。
更换网卡、调整 PCIe 设备或者硬件维修后,应重新核对MAC、PCI 地址、物理槽位、链路状态避免把生产网线接错接口。
(五)重大网络修改必须保留独立控制路径
如果只有一条 SSH 连接,然后通过这条连接修改风险很高。
物理服务器应尽量保留iDRAC、iLO等独立管理通道。
(六)能用 VLAN-aware Bridge 时,不要无意义堆叠大量 Bridge
对于典型 Trunk 场景,可以采用本例这种统一的VLAN-aware Bridge让网络关系保持清晰。
但如果确实存在物理隔离、特殊路由、安全边界或独立 MTU 等要求,再使用独立 Bridge。
(七)MTU 先保持一致,再谈优化
生产环境网络稳定性优先于“参数看起来先进”。
没有明确需求时先使用标准 MTU。
需要 Jumbo Frame 时再进一步优化。