RAID 选型:容量、容错与性能
选 RAID,先看三个问题:需要多少可用容量,能接受怎样的磁盘故障,业务主要产生什么读写请求。容量利用率和性能排名,只有放在这些条件下才有意义。
这些差异来自数据布局。本文以两盘 RAID 1、固定双盘镜像组组成的 RAID 10 为例;部分软件 RAID 支持其他布局,盘数和容错条件也会不同。
一、数据怎样保存,决定了怎样恢复
RAID 通常称为“Redundant Array of Independent Disks独立磁盘冗余阵列”,是一种将多块磁盘组合起来,通过不同的数据组织方式,提高读写性能或提供磁盘故障容错能力的存储技术。
理解 RAID,关键在于数据如何分布,以及故障后如何恢复。常见的核心机制有三种:条带化将数据分散到多块盘上,支持并行读写;镜像保存相同数据的副本;校验保存用于恢复缺失数据的冗余信息。不同 RAID 级别采用不同的机制或组合,由此形成容量、性能和容错能力上的差异。
条带化把数据分块放到多块盘上,使它们有机会并行处理请求。RAID 0 只有条带化,没有冗余;一块成员盘故障,阵列就无法提供完整数据,也无法自行重建缺失内容。
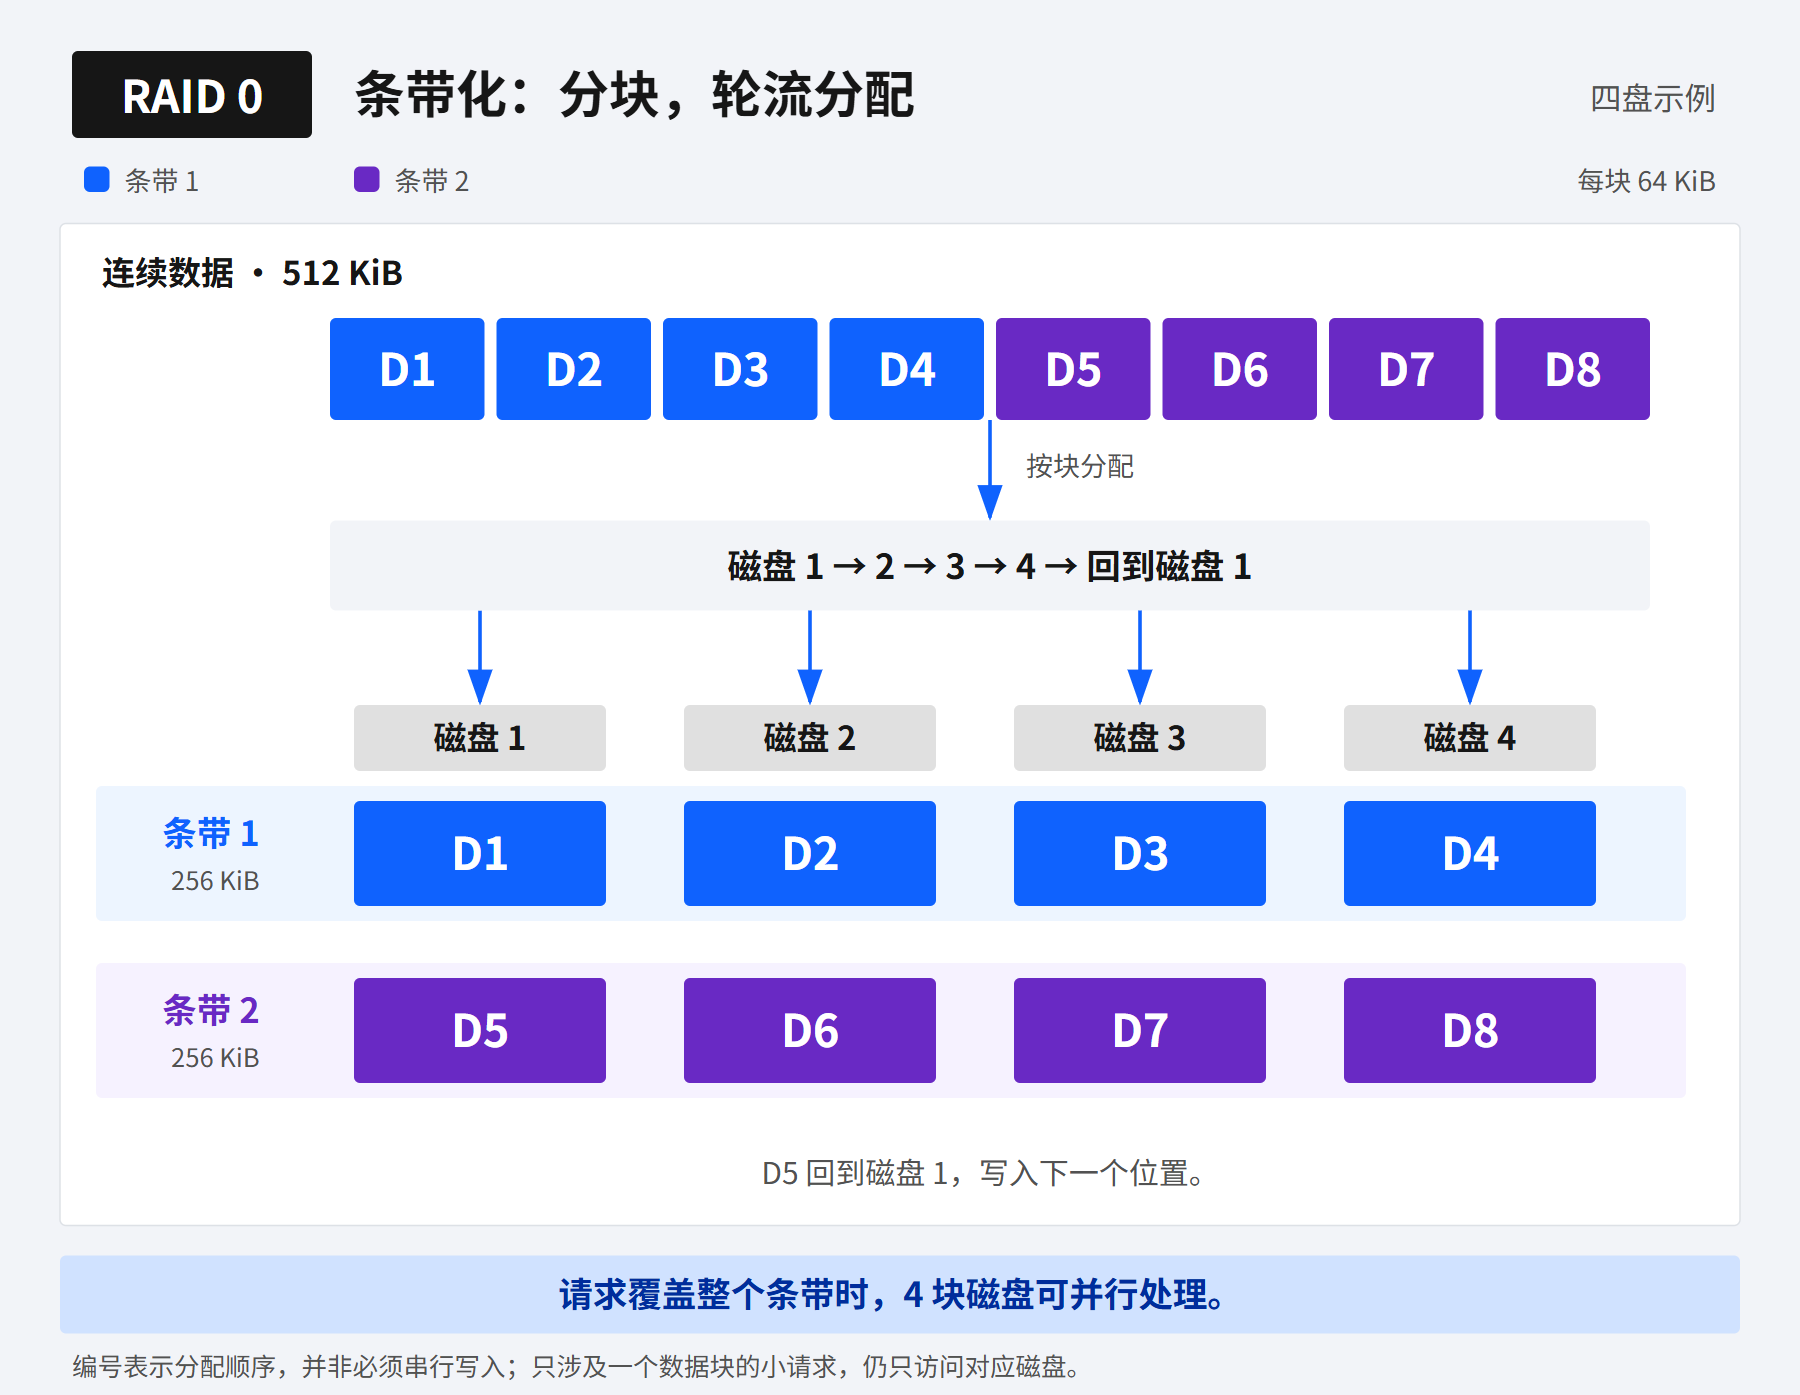
什么是条带化:条带化会把连续的数据切成固定大小的块,再按顺序分配到各块磁盘。
以四盘 RAID 0 为例,假设每块数据大小为 64 KiB,前四块依次写入磁盘 1、2、3、4,共同构成一个条带;第五块再写到磁盘 1 的下一个位置,继续轮流分配。当一个请求涉及多块磁盘,或多个请求分布在不同磁盘上时,各盘就能并行处理,从而提高吞吐量。不过,只访问一个数据块的小请求,并不会自动让四块盘一起工作。
镜像保存相同数据的多个副本。两盘 RAID 1 中,一块盘故障后可以继续使用另一块。RAID 10 则先组成镜像组,再在组间做条带化。
校验保存通过数据计算出的冗余信息。RAID 5、RAID 6 将条带化与校验结合,分别用一组、两组校验恢复缺失数据。它们没有保存完整副本,恢复需要依靠计算。
二、RAID 5 和 RAID 6 为什么能恢复数据
校验关系按条带建立。这里把跨成员盘的一组对应数据块及其校验块称为一个条带。RAID 5、RAID 6 的校验块分布在不同磁盘上,没有固定的专用校验盘。
RAID 5:用异或恢复一个缺失块
假设一个条带有 A、B、C 三个等长数据块,校验块为:
P = A ⊕ B ⊕ C
⊕ 表示按位异或。同一个值异或两次会抵消,所以 A 丢失后,可以计算:
A = P ⊕ B ⊕ C
如果丢失的是 P,直接用数据重新计算即可。但 A、B 同时丢失时,只能得到 A ⊕ B,无法确定两者各自的内容。因此,RAID 5 能容忍一块成员盘故障。

RAID 6:用两组校验恢复两个缺失块
RAID 5 的一组校验只能恢复一个缺失的数据块。要恢复两个缺失块,还需要增加一条独立的恢复关系,因此 RAID 6 引入了第二组校验 Q。
P 通过异或计算,Q 则采用不同系数的加权运算,两者都由同一条带的数据生成。
当两个数据块同时丢失时,可以把它们看成两个未知数。利用剩余数据和 P、Q,能够建立两条独立关系,求出这两个未知数,恢复缺失内容。
这类似于用两个独立方程求解两个未知数;如果 Q 只是 P 的副本,就没有增加新的关系,也无法恢复第二个缺失块。

图示为常见 P、Q 实现;Q 的加权运算在有限域中进行。恢复要求缺失位置已知,剩余数据与校验正确且可读。
三、容量和容错要放在一起比较
假设成员盘容量均为 S,盘数为 N,不计热备盘、元数据和文件系统开销。阵列原本健康,故障后剩余内容满足上述恢复条件,各级别的容量与容错能力如下:
| RAID 级别 | 最少硬盘数 | 理论可用容量 | 容量利用率 | 整盘故障容忍条件 |
|---|---|---|---|---|
| RAID 0 | 2 | N × S | 100% | 不容忍成员盘故障 |
| 两盘 RAID 1 | 2 | S | 50% | 任意一盘 |
| RAID 5 | 3 | (N−1) × S | (N−1) / N | 任意一盘 |
| RAID 6 | 4 | (N−2) × S | (N−2) / N | 任意两盘 |
| 双副本 RAID 10 | 4,N 为偶数 | N × S / 2 | 50% | 每个镜像组至少保留一盘 |
RAID 5、RAID 6 分别“占用一块、两块盘”,说的是等效容量开销。以 4 块 8 TB 硬盘为例,RAID 0、5、6、10 的理论可用容量分别为 32、24、16、16 TB。这里使用硬盘标称的十进制 TB,系统若以 TiB 显示,数值会不同。
4 盘 RAID 6 和 RAID 10 的容量利用率都是 50%;换成 8 盘,RAID 6 提高到 75%,RAID 10 仍为 50%。增加校验阵列的盘数能降低冗余空间占比,但也需要重新评估故障影响范围和重建时间。
RAID 10 的容错还取决于故障分布。假设磁盘 1、2 为一组,3、4 为另一组:磁盘 1、3 故障,每组仍有副本;磁盘 1、2 故障,一组的两个副本都丢失。因此,“最多能坏一半”只适用于每组各坏一盘的情况,
RAID 6 则可以容忍任意两盘故障。
坏盘后,阵列还需要重建数据、恢复冗余。重建期间,读写性能可能下降,应对进一步故障的能力也会减弱。因此,选型除了看能容忍几块坏盘,还要评估重建需要多久,以及业务能否承受这段时间的性能下降。
四、写入为什么会产生额外开销
RAID 的冗余不仅占用容量,也会增加写入工作量。镜像阵列需要把数据写入多个副本;校验阵列修改数据时,还需要更新相关校验。因此,应用发出一次写入,底层磁盘可能要执行多次读写。
这种额外的读写开销通常称为写惩罚,常用一次逻辑写入对应的成员盘 I/O 次数来衡量。例如,一次写入引发了两次磁盘读取和两次磁盘写入,写惩罚就是 4。
1.RAID 5 和 RAID 6 如何更新校验
以 RAID 5 修改一个数据块为例:如果旧数据和旧校验没有命中缓存,采用“读—改—写”方式时,需要先读取旧数据 A 和旧校验 P,再计算新校验:
1 | P′ = P ⊕ A ⊕ A′ |
这个计算先抵消旧 A,再加入新 A′。随后写入新数据 A′ 和新校验 P′,共计 2 次读+2 次写=4 次 I/O。
RAID 6 还需要更新第二组校验 Q,因此同样的更新过程需要读取旧数据、旧 P、旧 Q,再写入新数据、新 P、新 Q,共计 3 次读+3 次写=6 次 I/O。
按这一模型,各级别的写惩罚如下:
| RAID 级别 | 成员盘操作 | 写惩罚 |
|---|---|---|
| RAID 0 | 写一份数据 | 1 |
| 双副本 RAID 1、RAID 10 | 写两份数据 | 2 |
| RAID 5 | 2 次读+2 次写 | 4 |
| RAID 6 | 3 次读+3 次写 | 6 |
2.写惩罚怎样影响性能
额外读写会占用磁盘的处理能力。在小块随机写较多时,校验阵列通常要承担更大的 I/O 开销,可能降低写入吞吐量、增加时延。但 I/O 次数不等于耗时倍数,写惩罚为 4,并不代表一次写入一定慢四倍。
表中的数值适用于健康阵列中、缓存未命中的单数据块更新,并且不计日志和元数据等额外操作。
如果写入覆盖整个条带,就可以直接用新数据生成校验,省去读取旧内容的步骤。缓存合并和其他校验更新方式也会改变实际开销,因此不能只凭写惩罚数值判断阵列性能。
五、不同场景,RAID 怎么选?
了解容量、容错和写入开销后,就可以把这些差异对应到实际业务。选型主要看三点:需要多少可用容量、要求容忍几块盘故障,以及业务的读写特点。
| 使用场景与要求 | 推荐方案 | 选择理由 |
|---|---|---|
| 临时处理区、可重新生成的中间数据,允许坏盘后停机重建 | RAID 0 | 没有冗余容量开销,支持多盘并行读写,但不提供故障保护 |
| 只有两块硬盘的小型服务器,需要单盘故障保护 | RAID 1 | 通过镜像保留副本,可用容量为总容量的一半 |
| 读多写少的文件共享、资料库,重视容量利用率,接受单盘容错 | RAID 5 | 只付出一块盘的等效容量开销,适合写入压力较小的业务 |
| 使用大容量机械硬盘的文件、归档存储,需要任意两盘容错 | RAID 6 | 双校验提供更大的容错余量,代价是两块盘的等效容量和额外写入开销 |
| 小块随机写密集的事务型数据库、多虚拟机环境,对响应时间要求较高 | RAID 10 | 无需更新校验,适合高频随机写,但一半容量用于镜像 |
同样是数据库,查询为主和频繁更新的选择可能不同,因此要按实际读写特点判断。以上建议主要适用于常规机械硬盘阵列;全闪存及带有专门优化的存储系统,应结合厂商建议和实际测试确定。
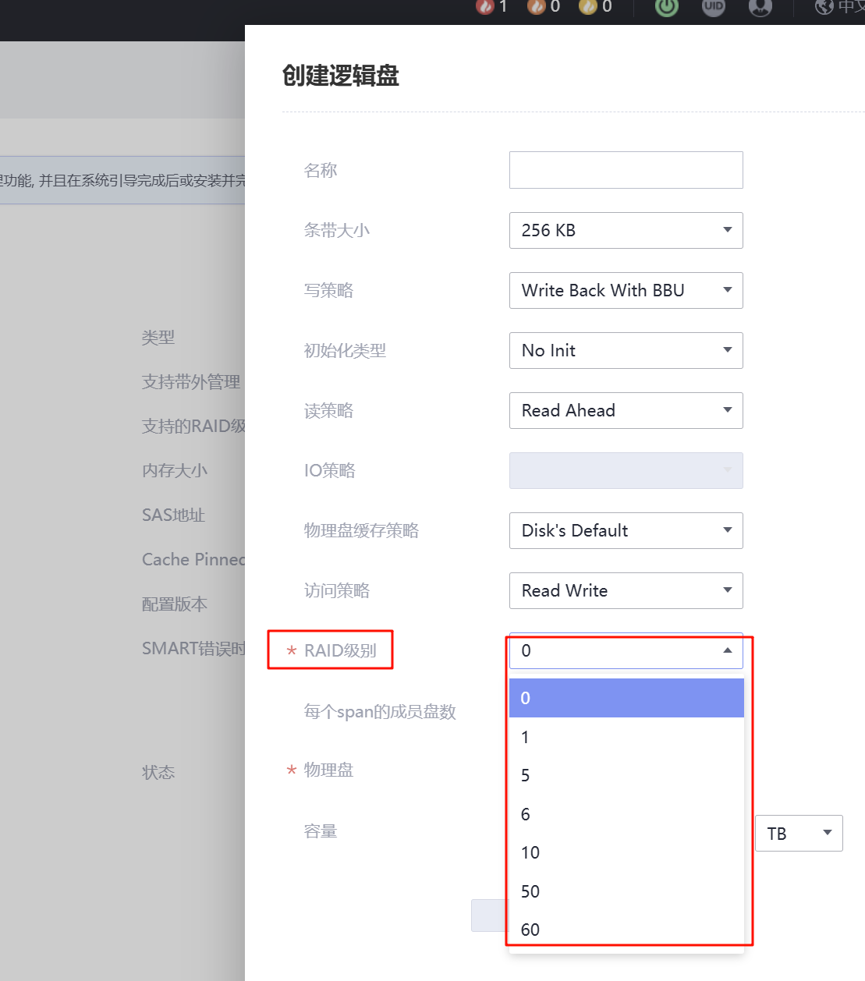
确定 RAID 方案后,就可以在存储管理界面中创建逻辑盘。如下图所示,前面讨论的 RAID 0、1、5、6、10,在实际操作中对应“RAID 级别”选项;成员磁盘、容量以及条带大小、读写策略等参数,则需要结合硬件和业务负载设置。
六、有了 RAID,为什么还要备份?
前面讨论的容错,解决的是磁盘故障后的数据恢复和业务连续性问题。但数据丢失不一定由坏盘引起:误删文件、覆盖内容或遭到勒索软件加密时,RAID 也会照常保存这些修改,无法靠镜像或校验找回修改前的数据。
因此,即使使用了具备冗余的 RAID,也需要保留可恢复的备份,并将备份与生产数据适当隔离。定期验证恢复过程,才能确认出问题后能找回哪个时间点的数据,以及恢复需要多久。
七、分布式存储与 RAID 有何不同?
RAID 之外,Ceph 等分布式存储也依靠冗余保护数据。
两者的主要区别在于:传统 RAID 通常在一组磁盘内实现容错,分布式存储则把冗余分散到多台服务器,并由集群协调恢复。
分布式存储常用多副本和纠删码:多副本保存多份相同数据,与镜像思路相通;纠删码将数据拆成数据片和校验片,用额外空间换取恢复能力,与 RAID 5、RAID 6 的校验思路相通。
关键是这些冗余放在哪里。如果几份副本都在同一台服务器上,整机故障时仍可能一起不可用。将副本或编码分片按规则分散到不同服务器、不同机架,才能在配置允许的范围内承受整机或机架故障。这种可能因同一次故障一起失效的范围,称为“故障域”。
故障发生后,集群可以利用其他节点上的数据,在健康节点上补齐副本或重建分片。
因此,分布式存储的可靠性既取决于冗余数量,也取决于故障域划分、网络和集群协调机制,以及是否有足够资源完成恢复。它扩大了容错范围,但同样不能替代备份。