Linux 日志系统的历史与使用
接手一台刚交付的服务器,服务起不来。你按习惯打开 /var/log/messages,发现文件是空的,甚至根本不存在。换成 journalctl 一查,启动失败的记录却明明就在那里。
日志并没有丢。你熟悉的那个文本文件,可能根本没有程序负责写入,而系统的日志服务一直在正常工作。
Linux 的日志之所以有这么多入口,要从它的历史说起。早期 Unix 留下了 syslog 的接口和分类规则。后来,rsyslog 扩展了收集和转发能力。再后来,systemd 带来了 journald。每一代新工具进入系统时,旧的接口和配置都没有随之退场,于是它们一层层叠在了一起。
顺着这段历史看下来,journalctl、rsyslog 和 logrotate 就不再是三套需要分别死记的命令。它们合起来回答的是四个问题:谁接收消息,怎样保存和查询,如何送往别处,什么时候清理。
一、从 syslog 到 journald
1. syslog:统一收集,按类别分发
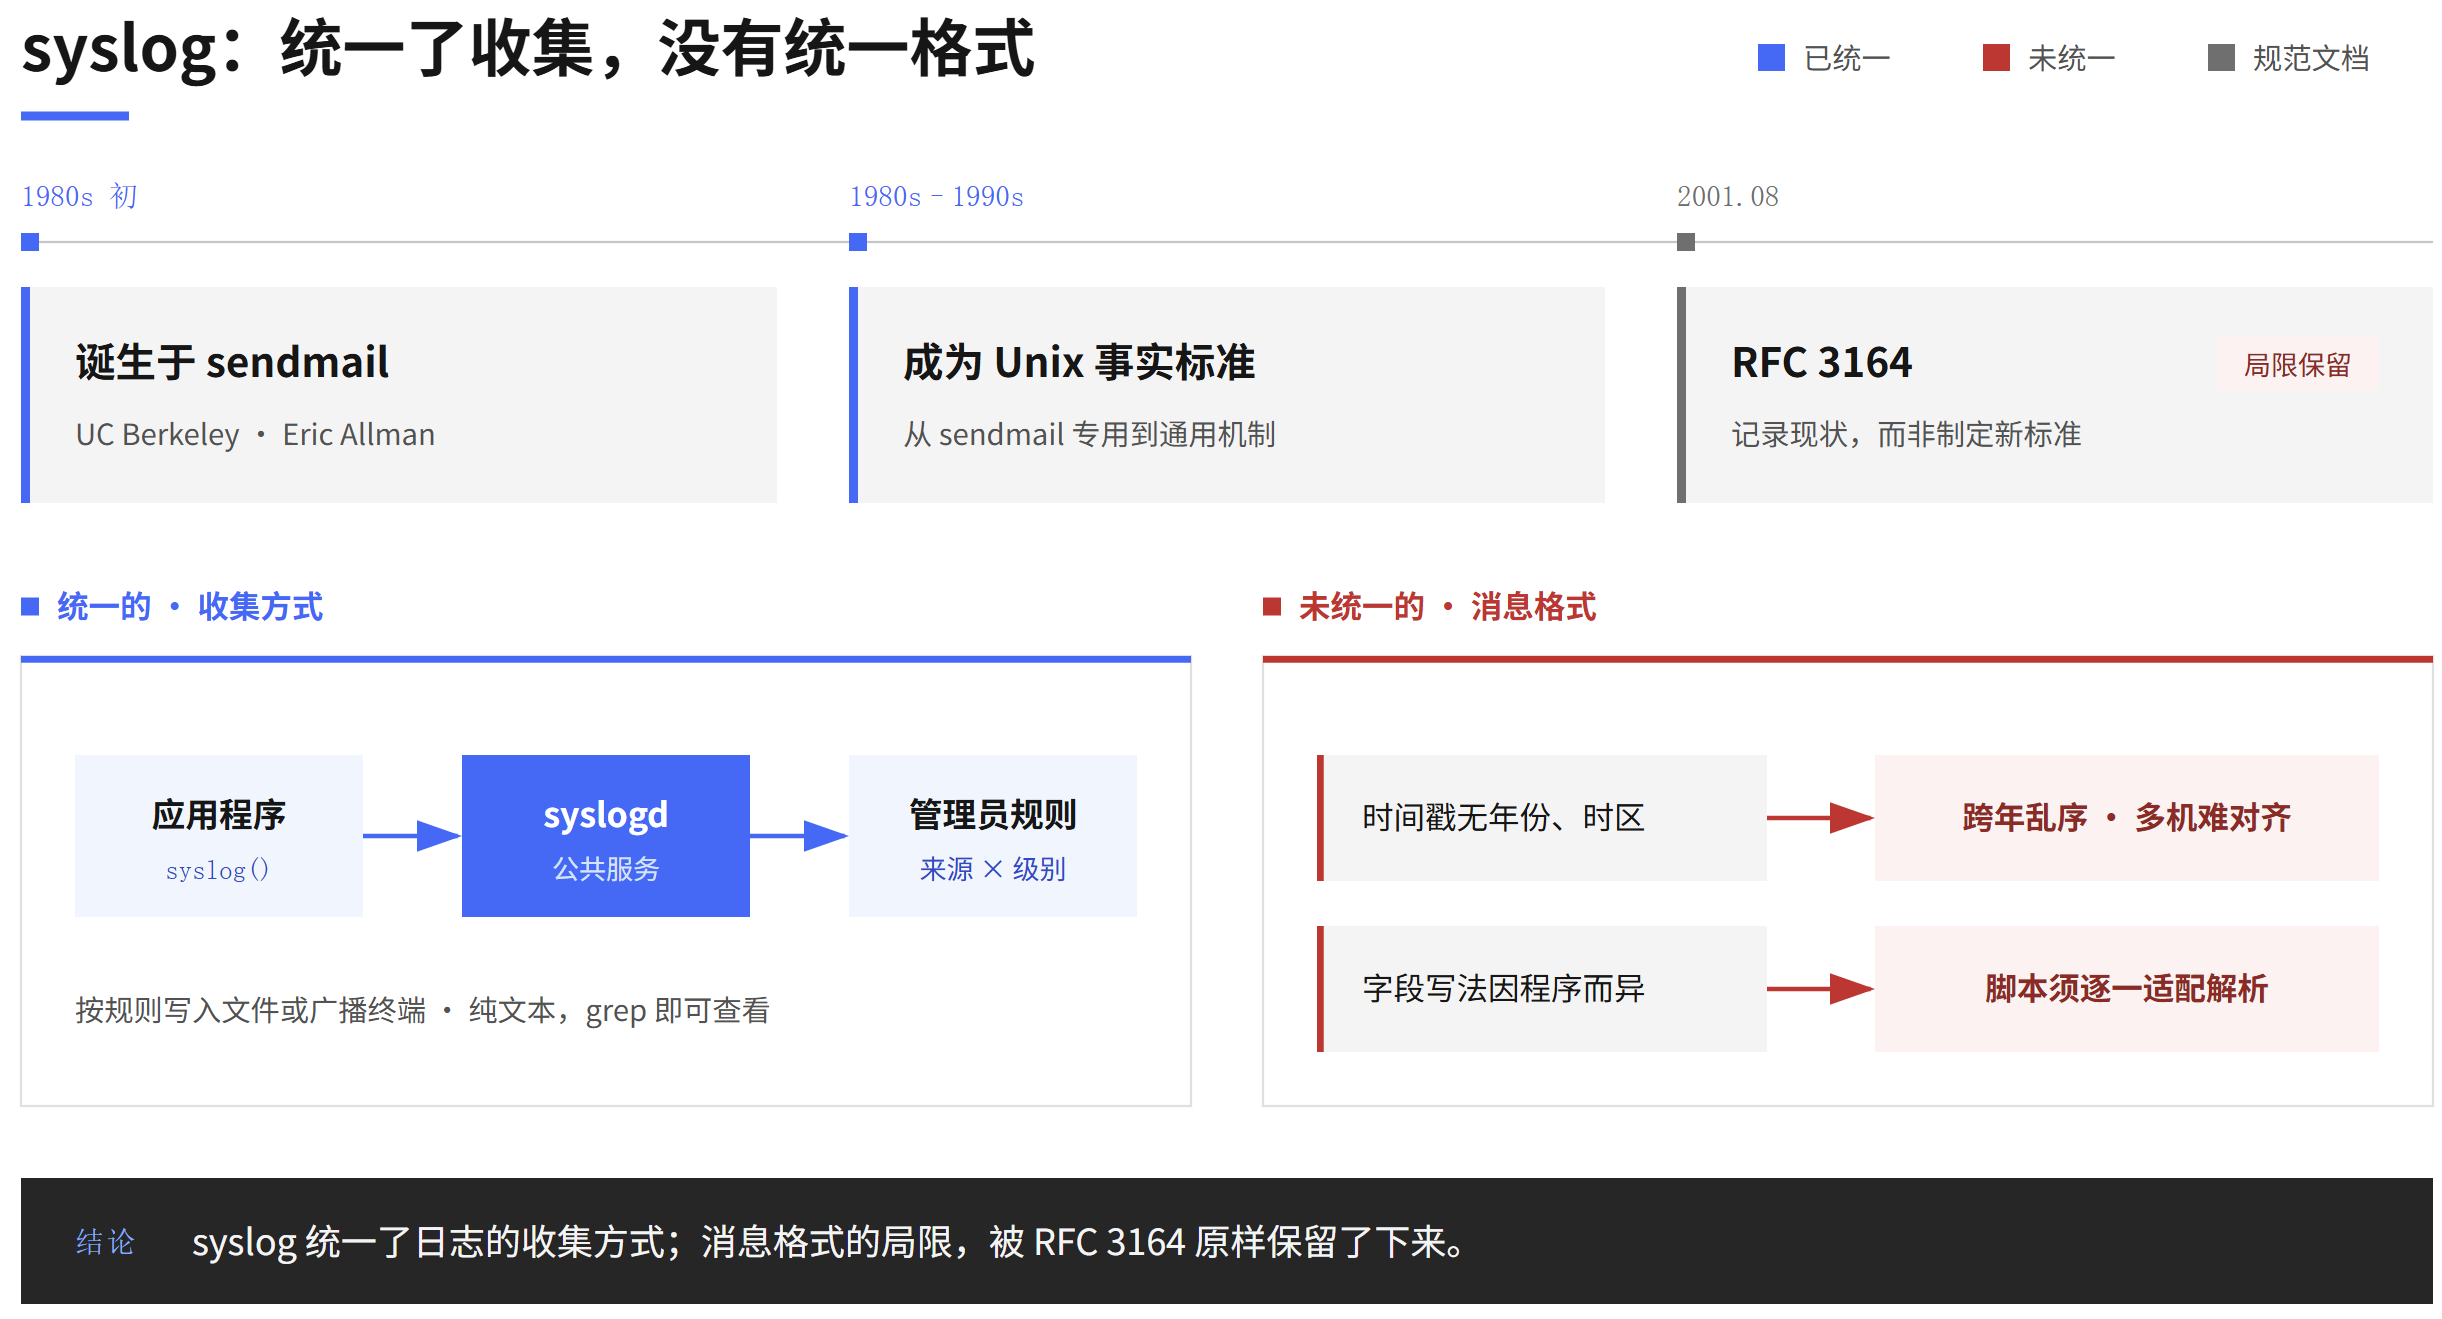
20 世纪 80 年代初,Eric Allman 在加州大学伯克利分校开发 sendmail 时编写了 syslog。他需要知道邮件系统在做什么:邮件何时投递成功,何时失败,为什么失败。syslog 的思路是让程序把消息交给一个公共服务,再由管理员统一决定这些消息存到哪里。sendmail 随伯克利的 BSD 发行版分发,syslog 也跟着进入了 BSD Unix。
syslog 起初只供 sendmail 使用,后来被越来越多的程序采用,逐渐成为 Unix 上事实标准的日志机制。应用只需调用 syslog() 提交消息,不用自己管理日志文件。管理员则按两个维度编写处理规则:消息来自哪类程序(facility,来源类别),以及事情有多严重(severity,严重级别)。比如,邮件日志单独存一个文件,认证记录写到另一个文件,出现紧急事件时向所有登录用户的终端广播。日志都是纯文本,用 cat、tail、grep 就能看。
不过,syslog 统一的只是收集方式,消息格式并没有统一。传统 BSD syslog 的时间戳只有月、日和时分秒,既没有年份,也没有时区。程序名、进程号和正文的写法也因程序而异。人工翻看少量日志时,结合上下文通常能看懂;一旦要用脚本批量处理,就得为每种格式单独写解析规则。
合并多台机器的日志时,问题更明显。没有时区,不同时区的主机就无法对齐到同一条时间轴上;没有年份,跨年的记录就可能顺序错乱。
在此后近二十年里,syslog 一直没有正式的协议规范,各家实现互不完全兼容。2001 年 8 月发布的 RFC 3164 以信息性文档(Informational)的形式,整理了当时通行的 BSD syslog 协议。它记录的是既有实现的做法,不是新定的标准,所以这些局限也被原样保留了下来。
2. syslog-ng 与 rsyslog:增强收集和转发
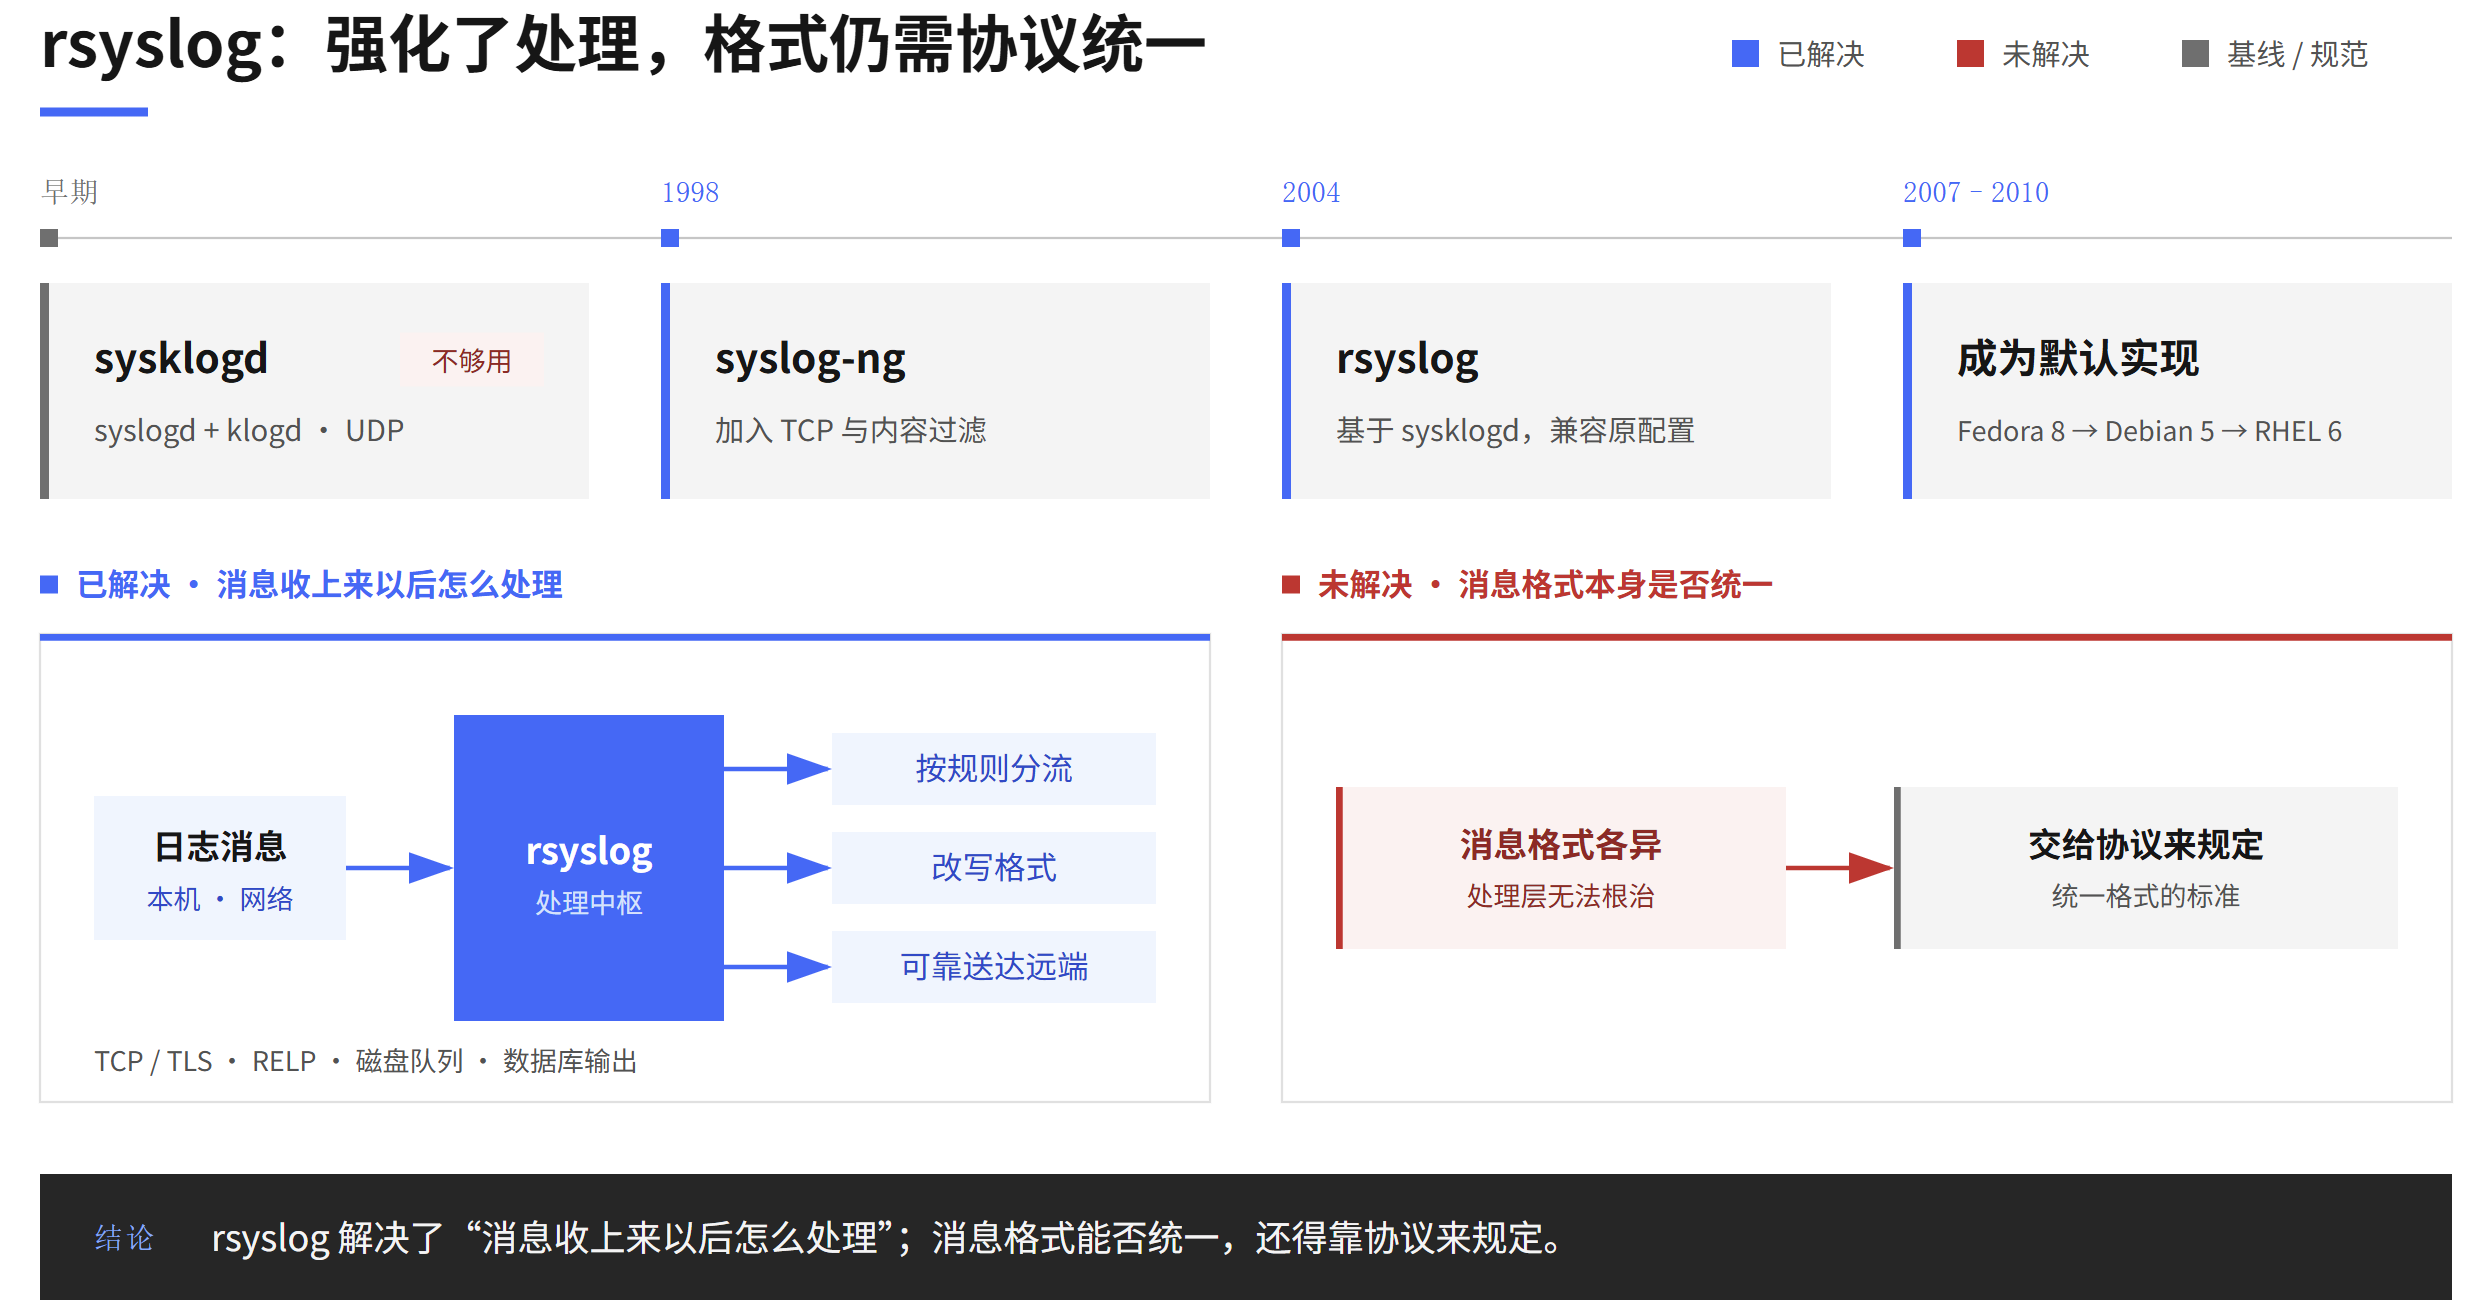
早期 Linux 发行版默认使用 sysklogd。它由两部分组成:syslogd 负责常规日志,klogd 负责读取内核消息。它的功能与 BSD syslog 基本一致:按 facility 和 severity 把消息写入文件,或者通过 UDP 发给其他主机。
服务器越来越多以后,集中收集日志成了刚需,这套实现开始不够用了。
1998 年,Balázs Scheidler 开始开发 syslog-ng,它加入了 TCP 传输和按消息内容过滤。
2004 年,Rainer Gerhards 在 sysklogd 的基础上开发了 rsyslog。它保留了原有的配置写法,又陆续加入了 TCP 与 TLS 传输、可靠传输协议 RELP、磁盘队列、数据库输出,以及表达力更强的配置语言。
此后,主流发行版先后把 rsyslog 设为默认的 syslog 实现:Fedora 8(2007 年)最先切换,Debian 5(Lenny,2009 年)随后跟进,RHEL 则从 RHEL 6(2010 年)开始默认使用 rsyslog。
rsyslog 主要解决的是”消息收上来以后怎么处理”:按规则分流、改写格式、可靠地送到远端。至于消息本身的格式能不能统一,还得靠协议来规定。
3. RFC 5424:给消息定下统一格式
2009 年 3 月发布的 RFC 5424 为 syslog 规定了统一的消息格式,在标准层面取代了 RFC 3164。这份标准的作者,正是 rsyslog 的开发者 Rainer Gerhards。
新格式有几处关键改进:
- 时间戳采用 RFC 3339 格式。只要给出时间,就必须带完整的年份和时区偏移,还可以带最多 6 位小数秒。只有在完全无法获取系统时间时,才允许用
-占位。 - 应用名、进程标识和消息标识各有独立的字段。
- 额外信息可以放进
STRUCTURED-DATA,按规定的键值对格式记录。
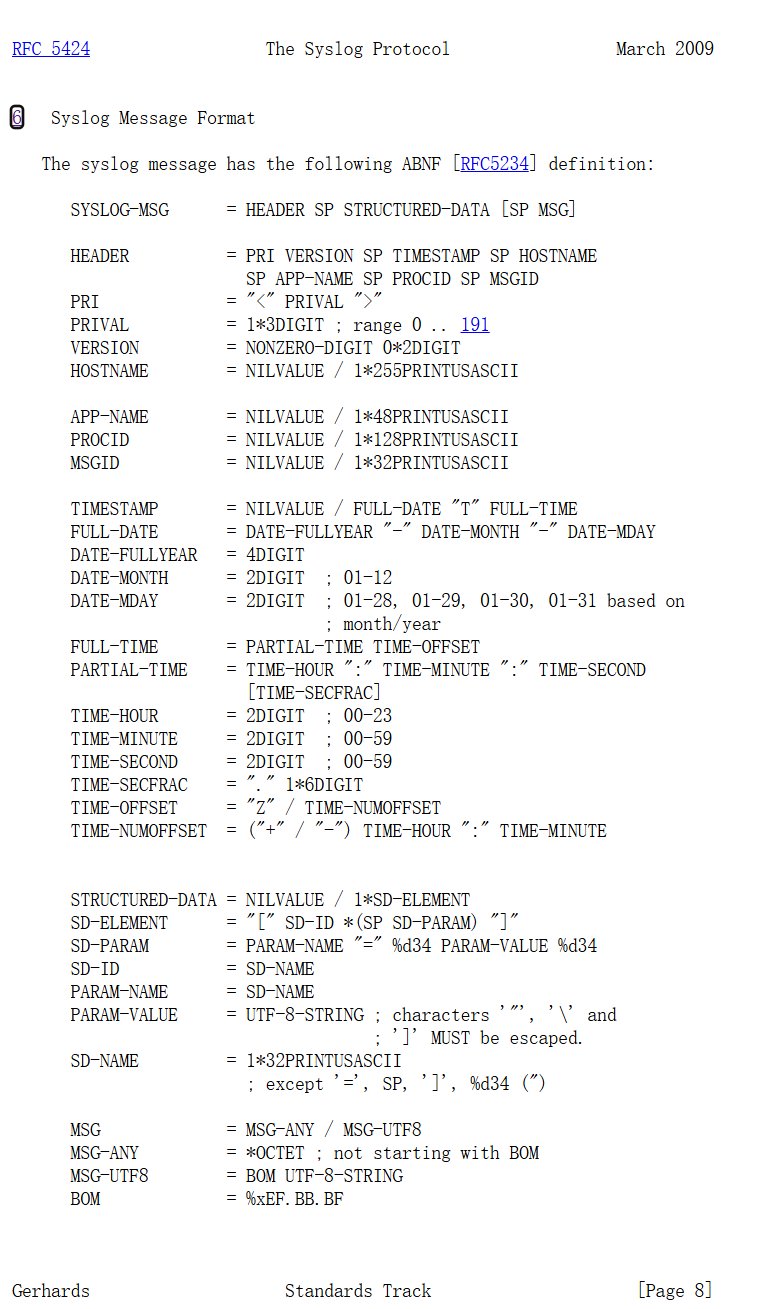
过去的日志,人能读懂,程序却很难稳定地解析。RFC 5424 要解决的就是这个问题:只要发送方遵守协议,接收方就能用同一套规则提取各个字段,不必再为每个程序单独编写解析逻辑。完整的时间信息,也让不同年份、不同时区的日志能够准确对齐。
不过,现实中仍有大量设备和程序在发送 RFC 3164 风格的消息,所以接收端通常两种格式都要能处理。
到这里,syslog 这条线已经补上了两块:rsyslog 管好了消息的处理和转发,RFC 5424 统一了消息格式。但还有一个问题始终没有解决:消息是谁发的,全靠发送方自己填写。程序名、进程号都写在消息里,填错了,甚至有意冒充,接收端都无从核实。
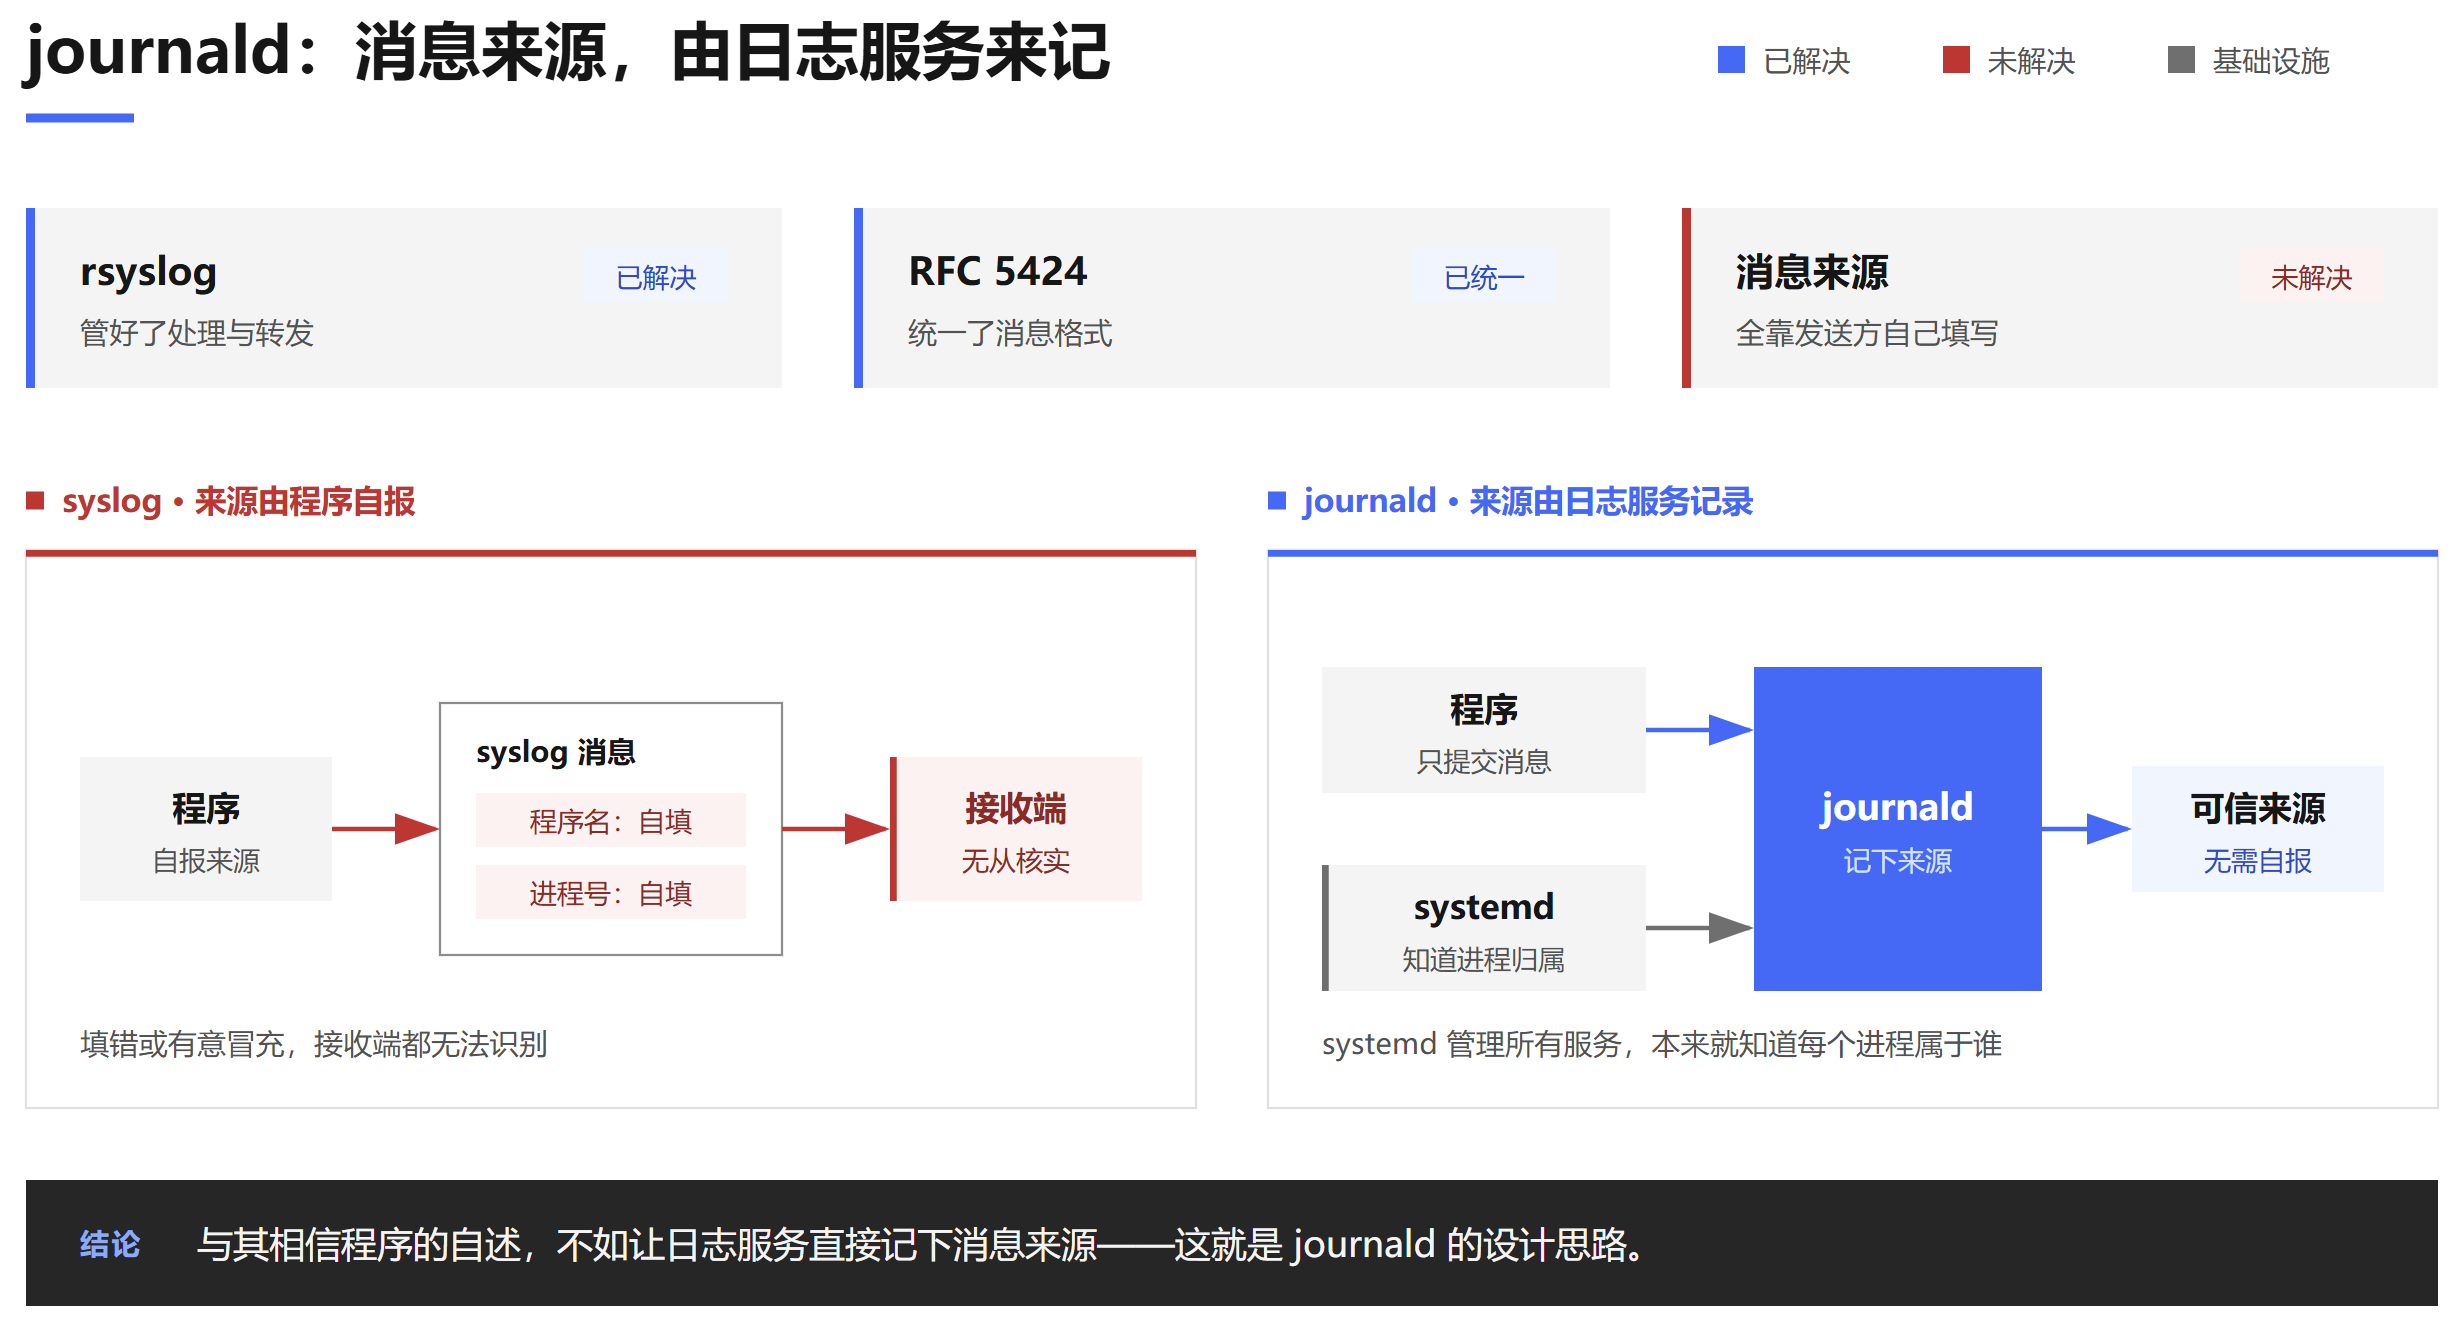
解决这个问题的思路来自 systemd。systemd 负责启动和管理系统上的所有服务,本来就知道每个进程属于哪个服务。既然如此,与其相信程序的自述,不如让日志服务直接把消息来源记下来。journald 就是按这个思路设计的。
4. journald:由日志服务记下消息来源
journald 是 systemd 自带的日志服务。2011 年 11 月,Lennart Poettering 等人公布了它的设计;2012 年 1 月发布的 systemd 38 是第一个包含 journal 的版本。
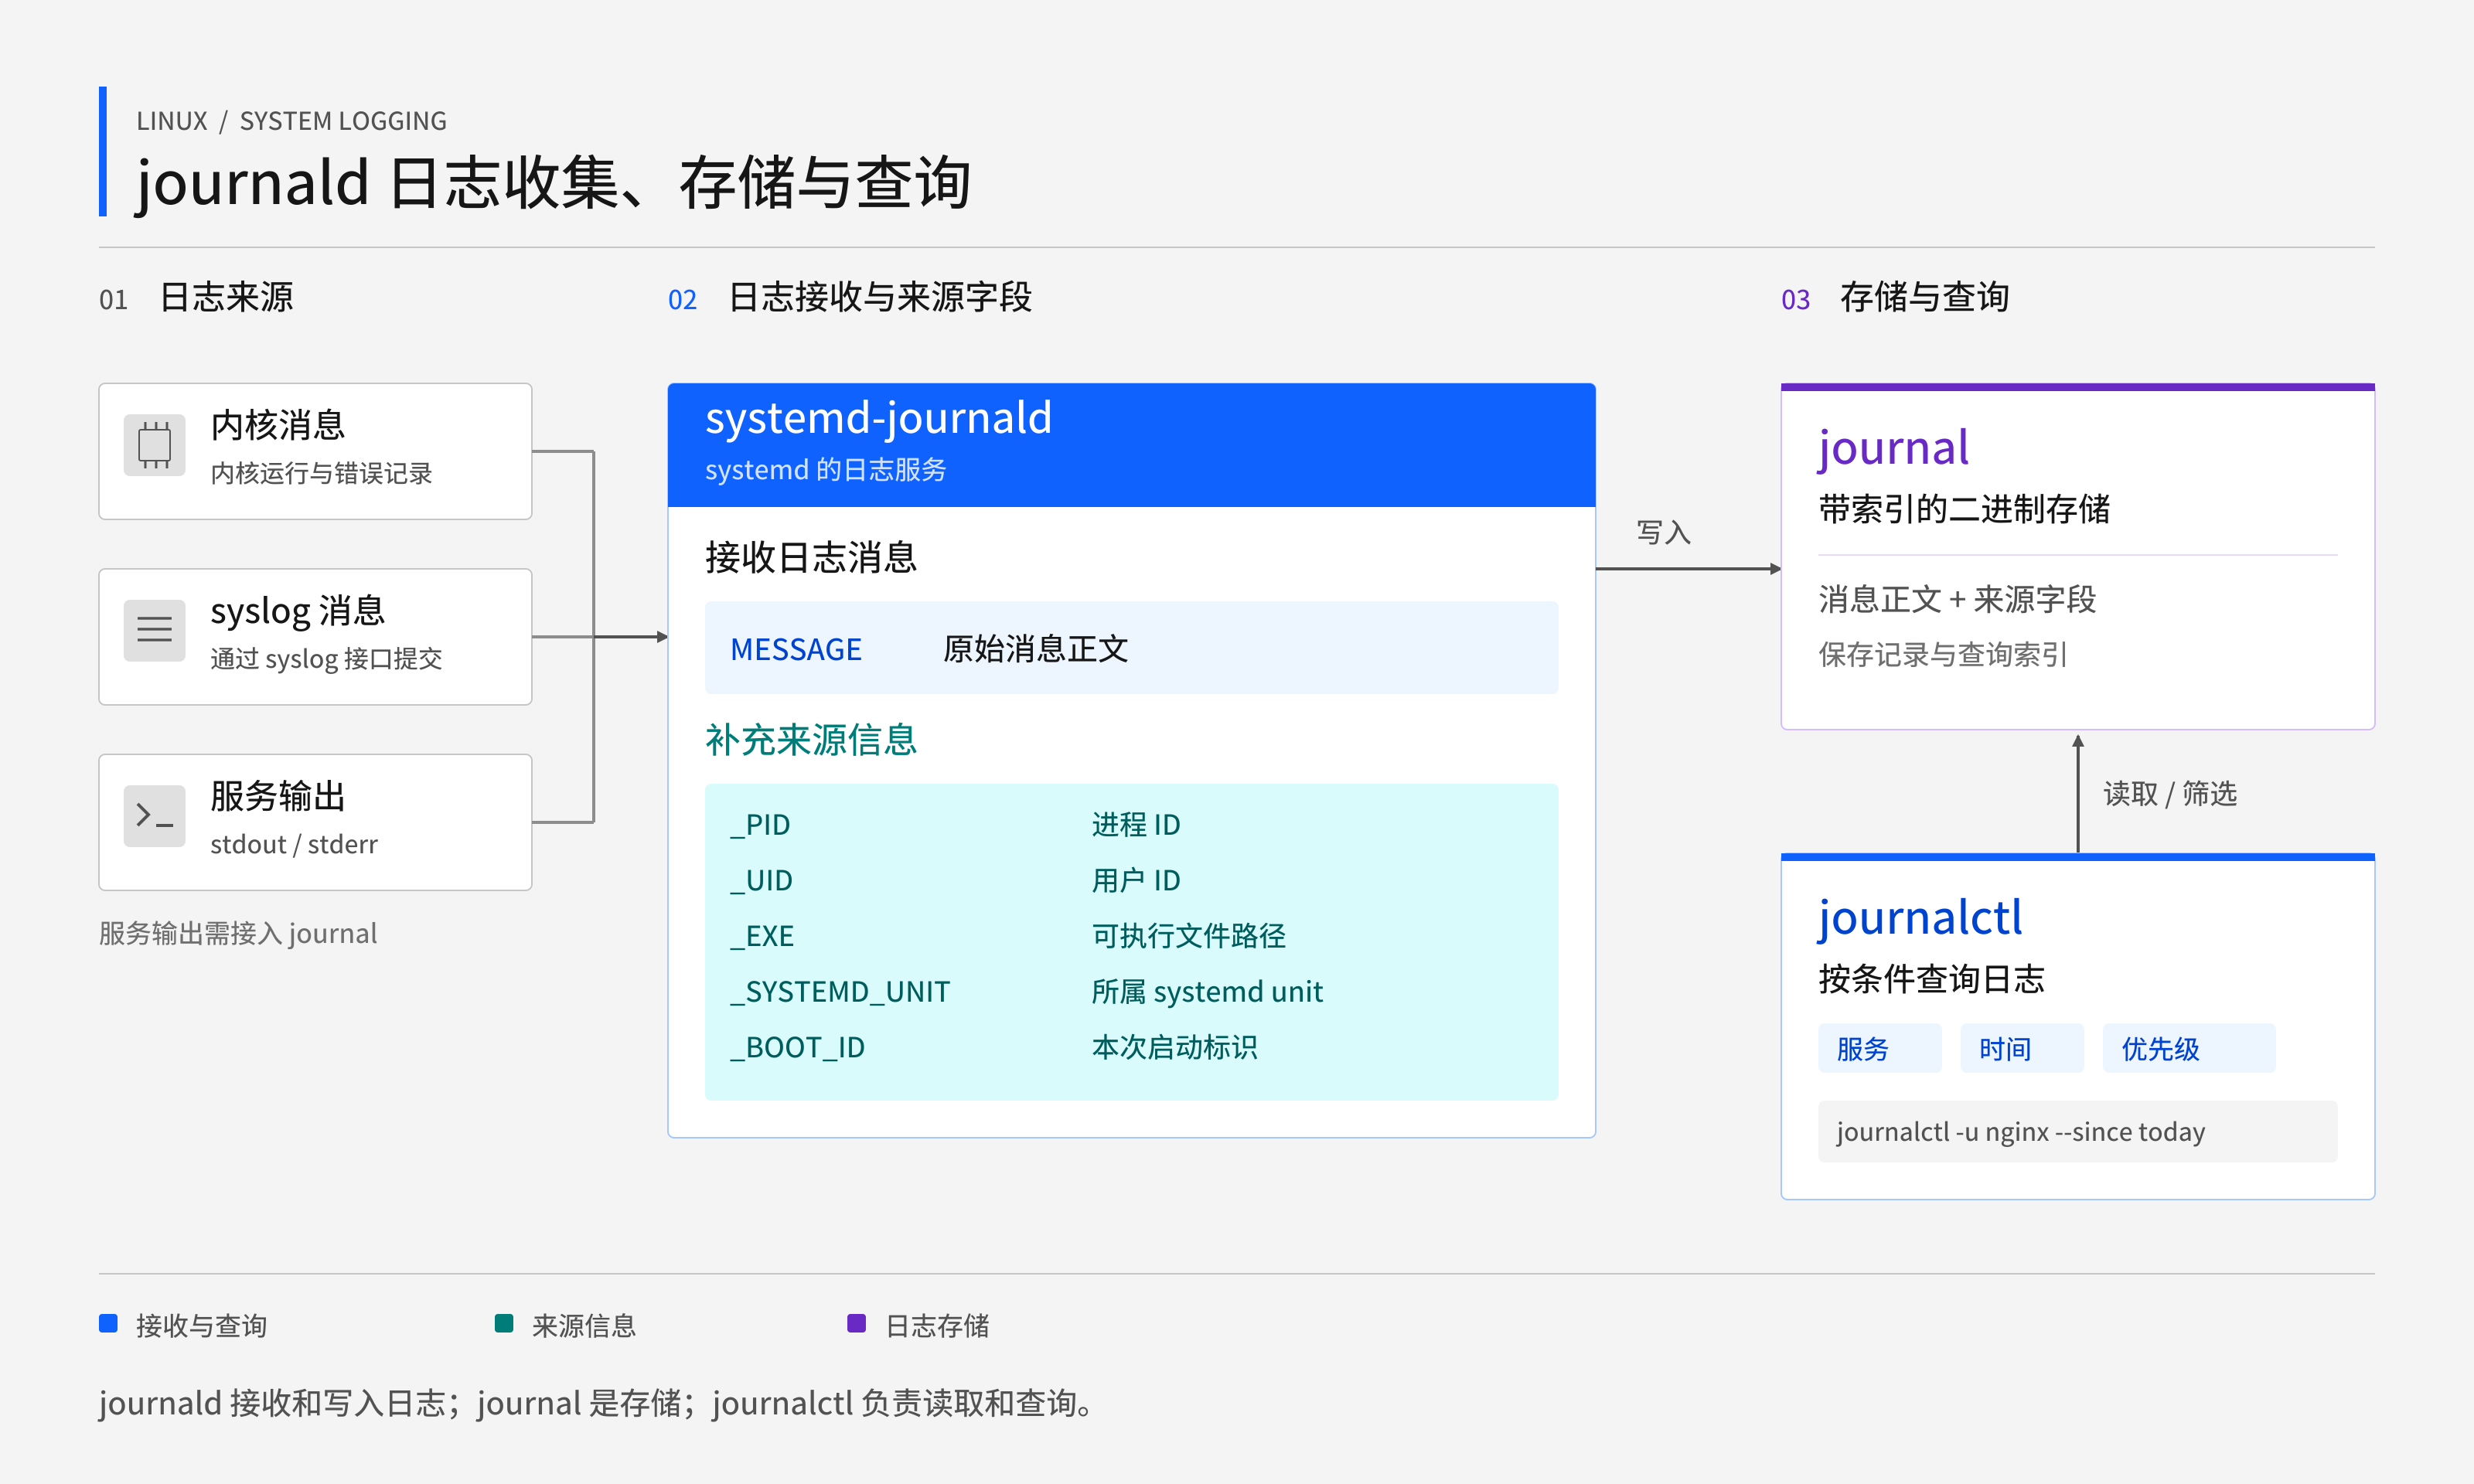
它为本机日志提供了另一套方案,接收的消息来源包括:
- 内核消息;
- 通过传统 syslog 套接字
/dev/log提交的消息; - 通过原生 journal API(如
sd_journal_send())提交的消息; - 服务的标准输出和标准错误;
- 内核审计(audit)记录。
这些消息统一保存在 journal 中。在使用 systemd 的系统上,连 /dev/log 都是由 journald 监听的。也就是说,应用调用 syslog() 时,消息的第一站是 journald,而不是 rsyslog。
journald 最大的变化在于:消息从哪里来,不再只靠程序在正文里自报家门,而是由 journald 自己记下来。每条消息除了正文,还附带进程 ID、用户 ID、可执行文件路径、所属的 systemd unit,以及本次启动的标识。排查服务故障时,这些信息比正文里自称的程序名可靠得多。为了能按这些字段快速查询,journald 采用带索引的二进制格式存储,查询则通过 journalctl 完成。
代价是底层文件不再是普通文本,读取和恢复都离不开能解析 journal 格式的工具。Linux 社区为此争论了很久。
这场争论常被概括为”文本与结构化之争”,但其实混在一起的是两个问题:
- 数据有没有结构。 RFC 5424 用纯文本就能表达结构化字段,rsyslog 也能处理结构化数据。结构化并不要求二进制。
- 文件用什么格式存储。 journald 选择二进制,是为了建立索引,加快按字段查询。
真正有争议的是后者。它是存储方式上的权衡(trade-off),而不是要不要结构化的分歧。
二、日志链路
上面几代工具,今天常常同时运行在同一台机器上。以 RHEL 8 的默认安装为例,执行下面的命令,可以看到 journald 和 rsyslog 都在运行:
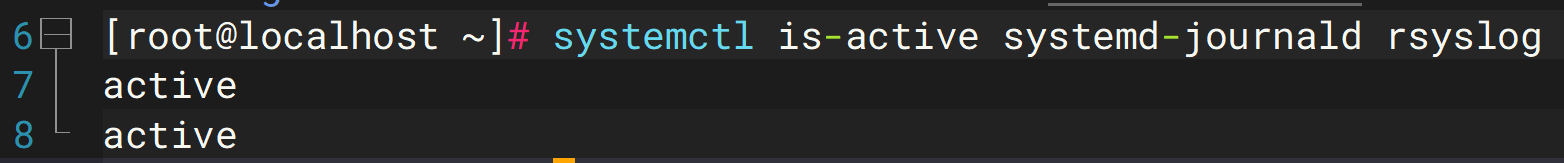
在这类系统上,journald 负责本机日志的收集、保存和查询,rsyslog 负责按规则处理、写入文本文件和远程转发,两者的能力有一部分重叠。rsyslog 和许多应用写出的文本日志都会不断增长,所以还需要 logrotate 定期轮转和清理。三者的常见分工如下:
| 工具 | 常见职责 | 典型问题 |
|---|---|---|
| journald / journalctl | 收集、保存和查询本机 journal | 这个服务什么时候报错?重启前发生了什么? |
| rsyslog | 接收消息,按规则处理、写文件或转发 | 认证日志写到哪里?怎样送到中央服务器? |
| logrotate | 定期轮转、压缩和删除文本日志 | 文件会不会一直增长?轮转后应用是否继续正常写入? |
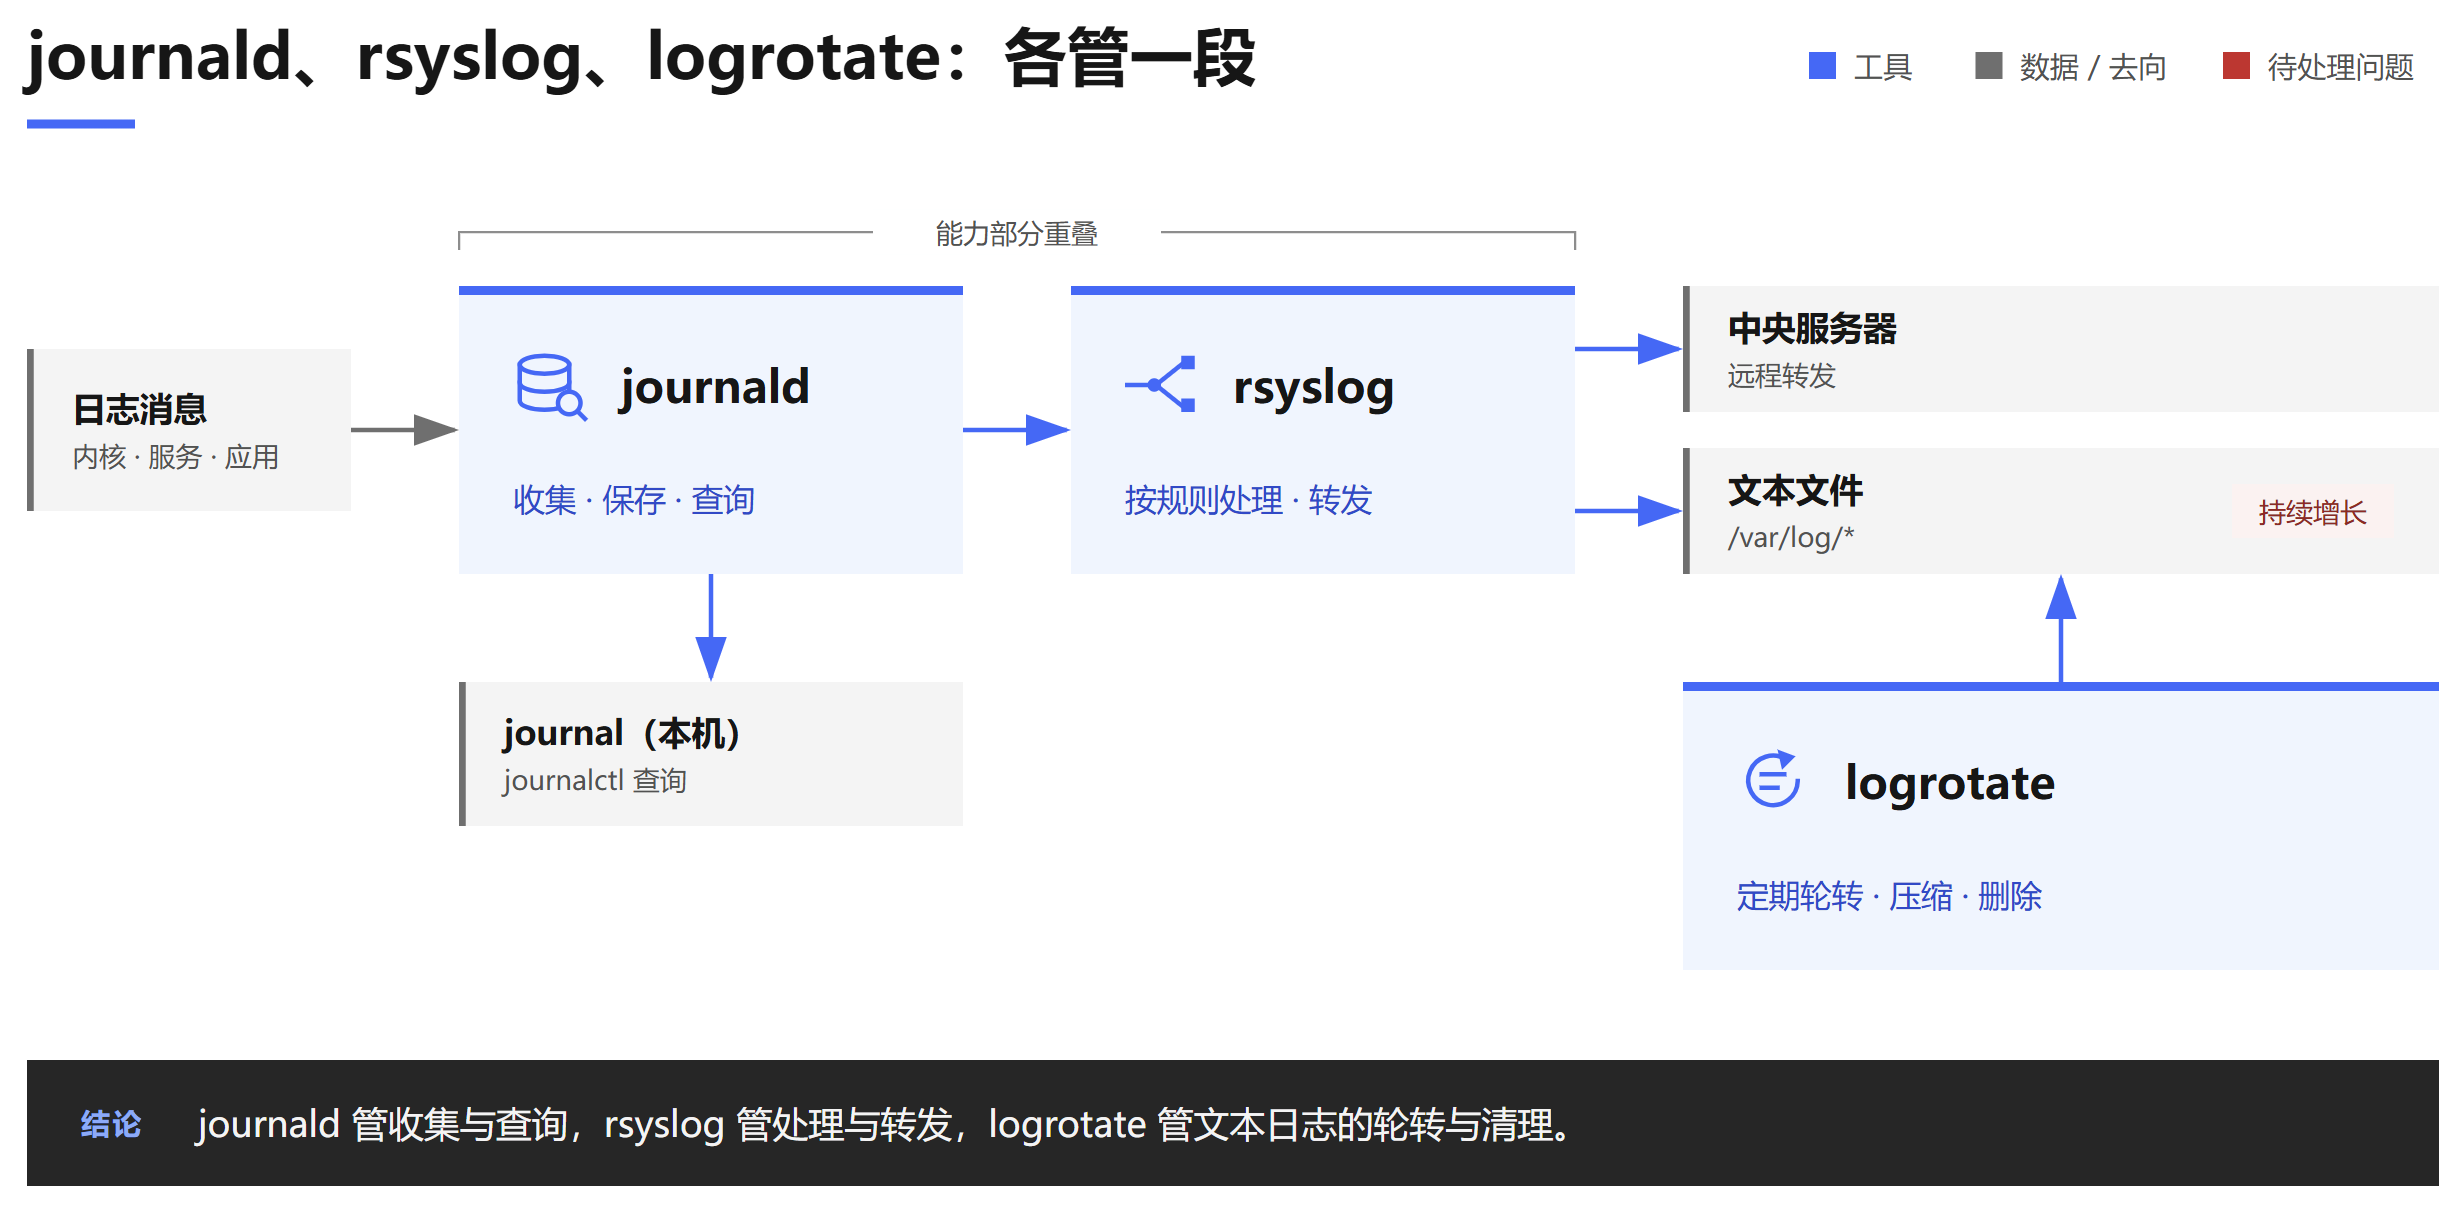
看这张图时,有几点值得特别注意:
本机日志的第一站是 journald。 程序通过 syslog 接口、标准输出或 journal 接口输出的日志,以及内核消息,都会先进入 journald。程序只决定用哪种方式输出,最终由谁接收是系统决定的。
rsyslog 拿到的是 journald 的”二手消息”。 rsyslog 不直接接收本机程序的日志,而是从 journald 获取:RHEL 上由 rsyslog 通过
imjournal主动读取 journal,Debian 上由 journald 开启ForwardToSyslog=yes后推送一份副本过来。同一批日志,可能各存一份。 journald 把日志写进自己的 journal:开启持久化时存在
/var/log/journal,否则存在内存中的/run/log/journal,重启即丢失。rsyslog 则把日志写成/var/log/messages、/var/log/secure(Debian 上是/var/log/syslog、/var/log/auth.log)等文本文件。两份数据来源相同,这也是图中二者”能力部分重叠”的原因。/var/log下的文件并非都出自 rsyslog。 图中的”文本文件”指的是 rsyslog 写出的那几个系统日志。nginx、dnf、apt 等应用会直接写自己的日志文件,auditd 写/var/log/audit/audit.log,登录记录则保存在wtmp、btmp等二进制文件中(用last、lastb查看),这些都与 rsyslog 无关。logrotate 只管文本文件,不管 journal。 rsyslog 写的文件和应用自己写的文件都由 logrotate 轮转;journal 则由 journald 按容量参数自行清理,不需要也不应该配置 logrotate。
在使用 systemd 的系统上,程序只决定用什么方式输出日志:自己写文件、调用 syslog 接口、打印到标准输出,或者调用 journal 接口。除了自己写文件,其余几种方式最终都会汇入 journald;装了 rsyslog 的系统,再由 rsyslog 从 journald 获取消息,写成文本文件。反过来,没装 rsyslog 的系统不会生成这些文本文件,依赖它们的工具就可能失效,第四章会讲到一个真实的例子。
journald 是 systemd 的组成部分,在使用 systemd 的系统上无法单独去掉。如果希望持久保存只交给 rsyslog,RHEL 7、8 的默认配置其实就是这样:journald 只把日志放在内存里,写到磁盘的工作由 rsyslog 完成。真正没有 journald 的,是不使用 systemd 的系统,比如 RHEL 6 及更早的版本,以及 Devuan 等发行版。在这些系统上,由 rsyslog 这类 syslog 服务直接监听 /dev/log、读取内核消息,也就是第一章介绍的传统 syslog 架构;程序打印到标准输出的内容,则需要由启动脚本自行重定向到文件。
所以,要看懂一台机器的日志配置,先要弄清消息走的是哪条路。同一条消息还可能既保存在本机,又被转发到远程服务器。/var/log 里的某个文件,只是这条链路上的一个去向。
现在可以回答开头的问题了。journal 里有记录,/var/log/messages 却是空的,最常见的原因有三个:
- 系统里根本没有运行 rsyslog。 例如 Debian 12 起默认就不再安装 rsyslog,日志只存在于 journal 中。
- rsyslog 在运行,但没有拿到消息,或者没有写这个文件的规则。 详见第四章第 4 节。
- 文件名本来就不对。 Debian 和 Ubuntu 上的综合日志文件叫
/var/log/syslog,不叫messages。
三、journal 的查询与存储管理
1. 用 journalctl 排查服务故障
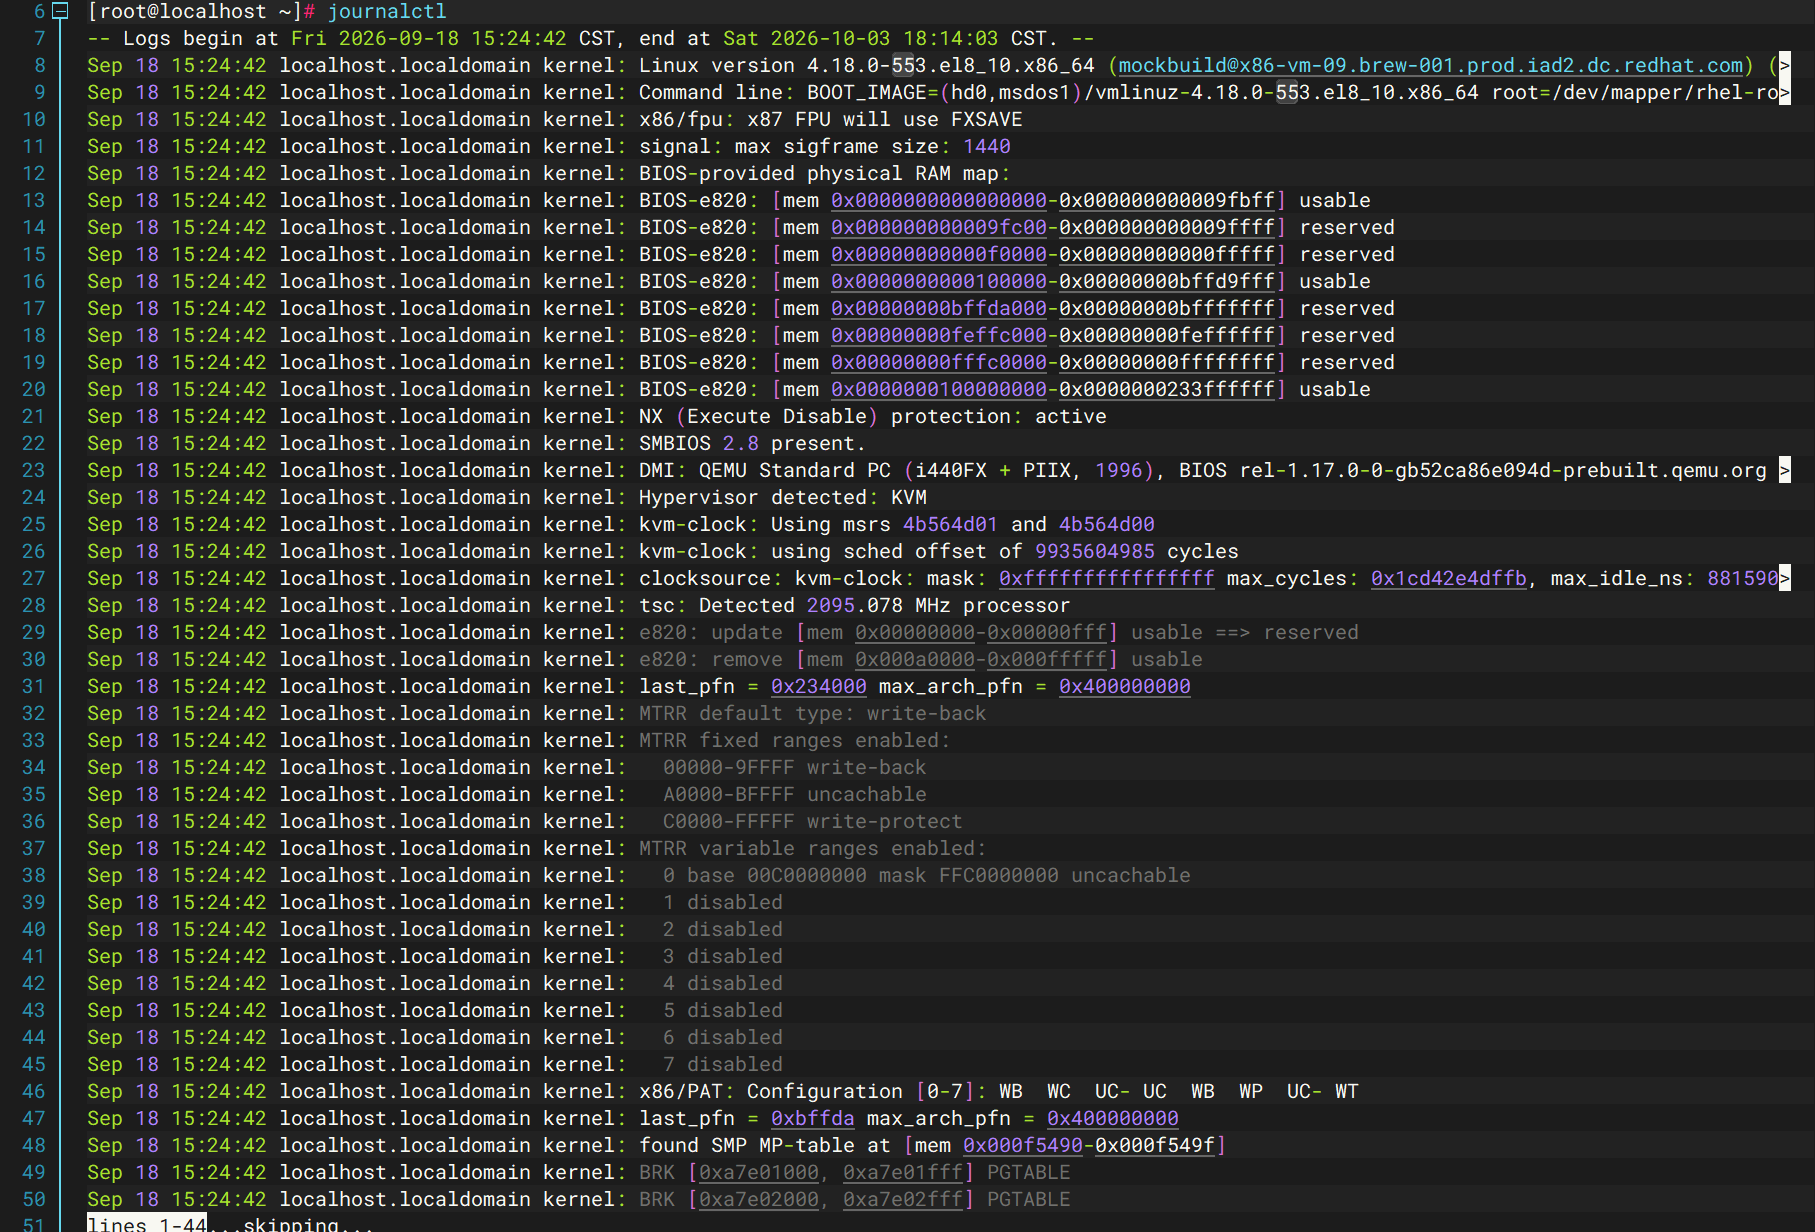
直接执行 journalctl,会从最早的一条记录开始,按时间顺序列出当前账号有权查看的日志,并进入分页界面(空格翻页,G 跳到末尾,q 退出)。这里混着内核和所有服务的消息,排查具体故障时,要先缩小范围。
服务启动失败时,第一条命令是:
1 | journalctl -xeu myapp |
较新版本的 systemd 在 systemctl start 失败时,提示信息里推荐的就是这条命令。三个选项的含义如下:
| 选项 | 含义 |
|---|---|
-x |
在日志条目旁附加 catalog 说明(解释性文字),例如服务启动失败的常见原因。只有在 journal catalog 中登记过的消息才有说明 |
-e |
直接跳到日志末尾(--pager-end),从最新的内容看起 |
-u myapp |
只显示指定 unit 的日志,等价于 --unit=myapp。myapp 对应 myapp.service,后缀可以省略 |
这些筛选条件可以自由组合,同时生效。下面是最常用的几种,完整用法见 man journalctl。
实时跟踪新日志,类似 tail -f:
1 | journalctl -u nginx -f |
查看最近 50 条,不进入分页:
1 | journalctl -u nginx -n 50 --no-pager |
按时间范围查看,可配合 --until 指定结束时间:
1 | journalctl -u nginx --since "30 min ago" |
--since的短选项是-S,--until的短选项是-U;--no-pager没有短选项。注意大写的-U和小写的-u(--unit)含义完全不同。
只看 err 及更严重的级别:
1 | journalctl -u nginx -p err |
按正文匹配(需要 systemd 237 及以上版本,可用 systemctl --version 查看):
1 | journalctl -u nginx -g 'timeout|refused' |
查看上一次启动的末尾。-b 指定看哪一次启动,后面跟的数字就是它的参数:0 为本次,-1 为上一次,以此类推。-e 表示直接跳到末尾:
1 | journalctl -b -1 -e |
-b -1 只能看上一次启动。如果要找的是更早的某次启动,先列出 journal 里保存的所有启动记录:
1 | journalctl --list-boots |
输出中每行是一次启动,第一列是编号,最后两列是这次启动期间第一条和最后一条日志的时间。根据时间找到目标那次启动,再把它的编号交给 -b。例如编号为 -2,就执行 journalctl -b -2 -e。
注意,
--list-boots能列出多少次启动,取决于 journal 是否持久化。如果用的是易失存储,重启后旧记录就没了,这里只会看到本次启动一行,详见本章第 3 节。
下图中只有一条启动记录,一种可能是 journal 没有持久化,之前的启动记录在重启时都丢了。

只看内核消息,默认只显示本次启动:
1 | journalctl -k |
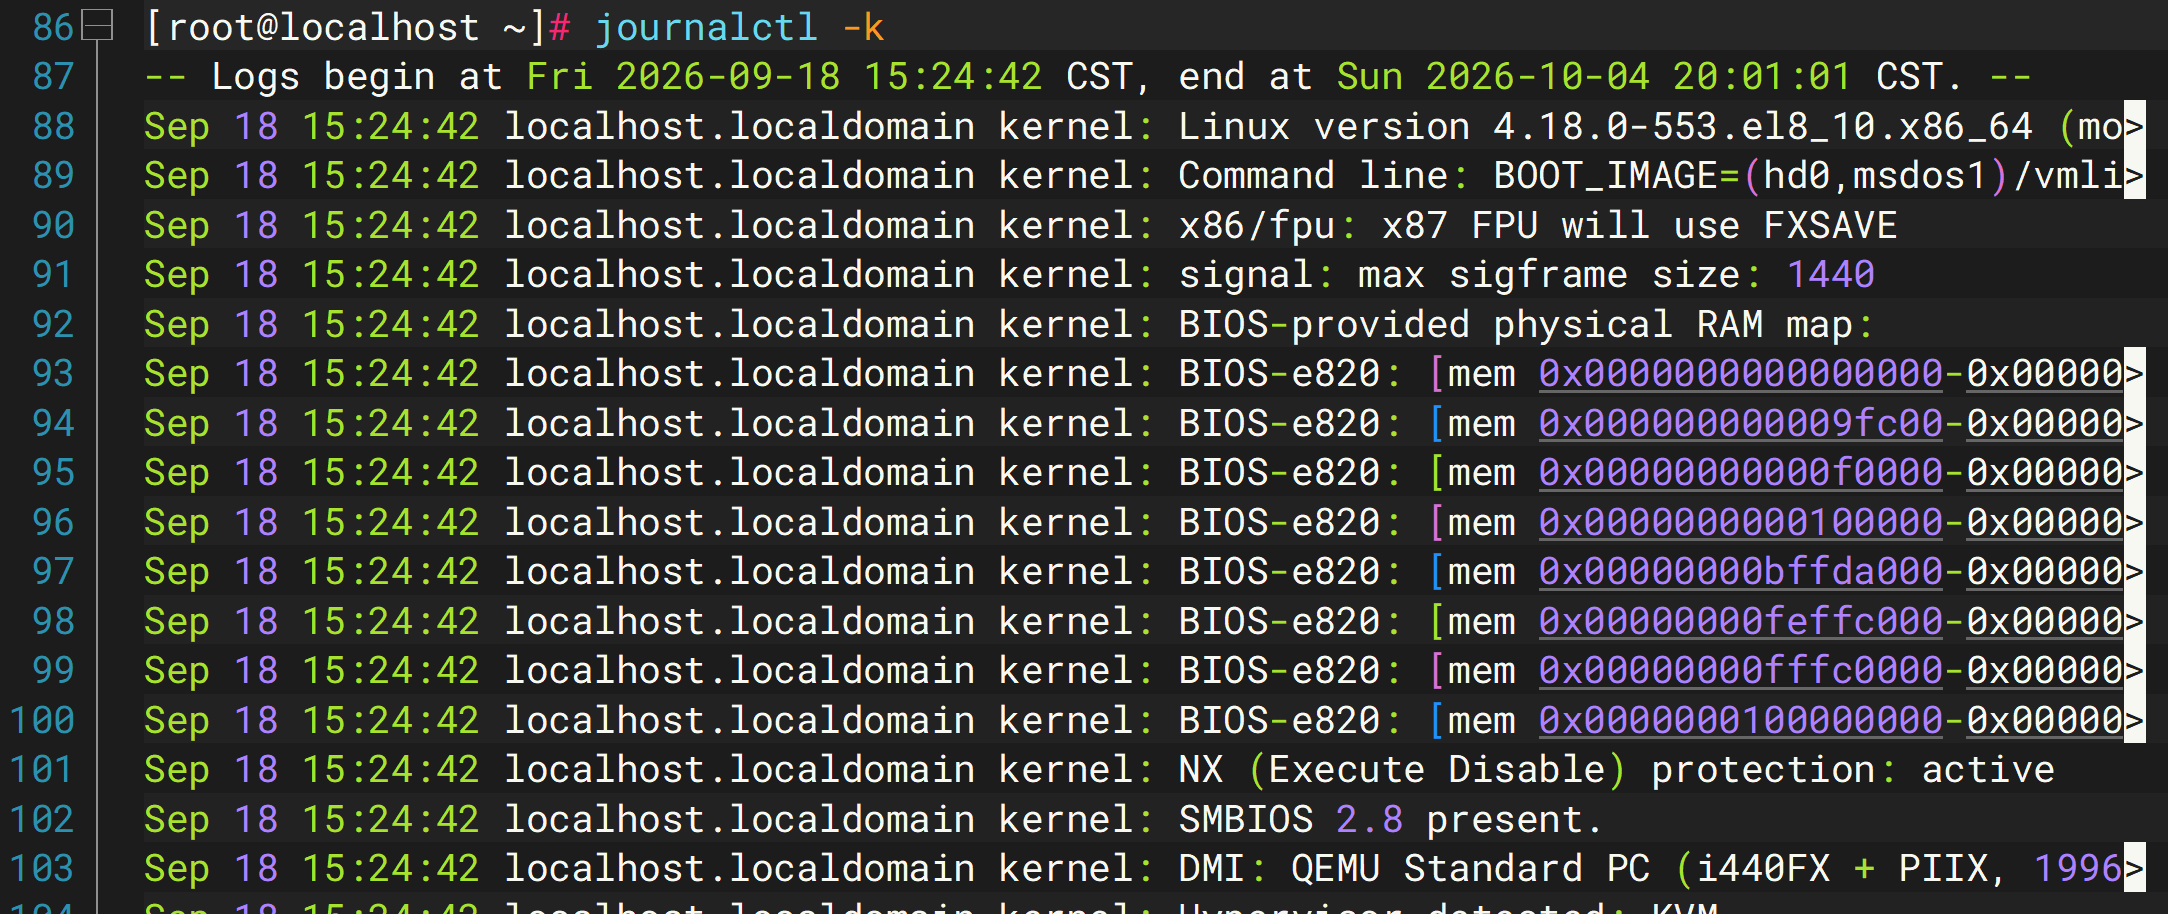
从上图第一行可以看出:journal 最早的记录正是本次启动的时刻。这说明这台机器从 9 月 18 日启动后一直没有重启,已经运行了 16 天左右,而且 journal 里没有比本次启动更早的记录。
使用这些命令时,有三点需要注意:
- 它们只能查到已经进入 journal 的记录。应用如果直接写自己的文件(如
/var/log/myapp/error.log),要到对应的文件里去看。 -b -1能否查到上一次启动,取决于 journal 是否持久化,详见本章第 3 节。- 服务名因发行版而异。比如 SSH 服务在 RHEL 上叫
sshd,在 Debian 和 Ubuntu 上叫ssh。本文示例统一用sshd,在 Debian 系上请自行替换。
还有一个小技巧:对齐不同来源的时间线时,可以加上 --utc,让 journal 的时间戳统一按 UTC 显示。它只改变 journal 自身时间戳的显示,应用写在正文里的时间字符串不受影响。
2. journal 字段与来源信息
默认输出只显示了每条记录的一小部分。换成 verbose 格式,就能看到全部字段:
1 | journalctl -u sshd -n 1 -o verbose |
下面是一条记录的示意:
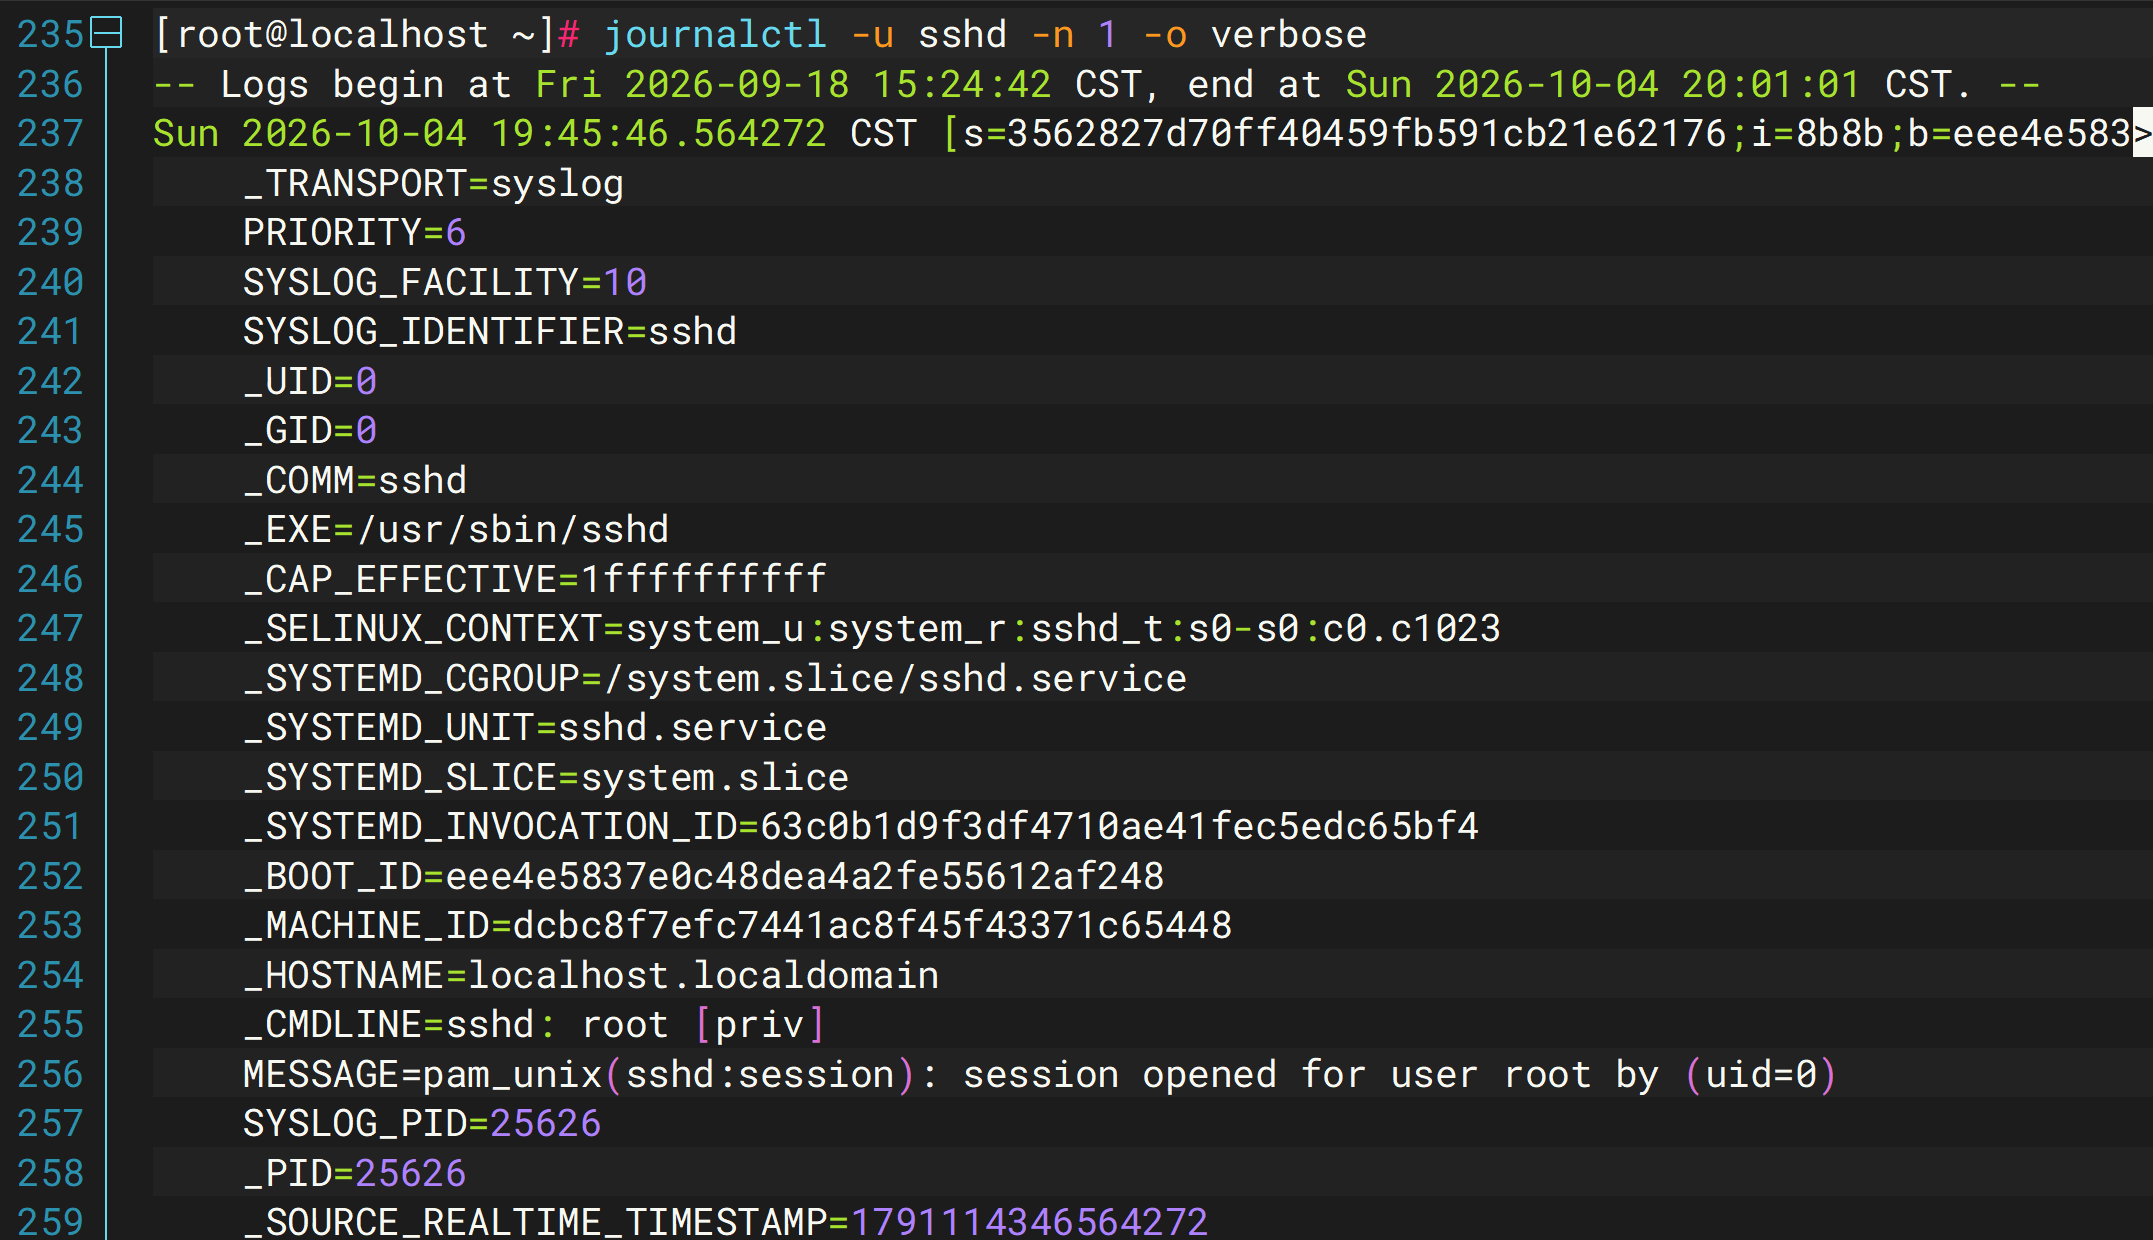
其中,MESSAGE、SYSLOG_IDENTIFIER 等字段由发送方提供。以下划线开头的字段则由 journald 自己补充,官方文档称为可信字段(trusted fields),客户端无法像提交普通字段那样填写或覆盖它们。
但”可信”的范围是有限的。可信字段能说明消息来自哪个进程、哪个服务,却不能保证正文内容属实,也不能保证主机被入侵后日志依然完整。
还有一个细节要注意。服务的标准输出和标准错误会通过一条连接接入 journald,从这条连接写入的所有内容,_PID 记录的都是最初建立连接的那个进程,通常就是服务的主进程。如果主进程又启动了子进程,子进程沿用同一个标准输出,它写入的内容也会记在主进程名下。
以下划线开头的这些字段,都可以直接作为查询条件。例如,journalctl _UID=1000 查看某个用户的进程产生的日志,journalctl _EXE=/usr/bin/python3 查看某个程序产生的日志。如果要交给脚本处理,加上 -o json 以 JSON 格式输出即可。
不过,日常查看服务日志时,还是优先使用 -u。它除了匹配服务自身写入的记录,还会带上 systemd 关于这个服务的消息,比如何时启动、何时停止、为什么失败,比单独匹配 _SYSTEMD_UNIT= 更完整。
3. journal 持久化
journald 一直在记录日志,但这些记录不一定写到了磁盘上。
在易失存储模式下,日志保存在 /run/log/journal 中。/run 是内存文件系统,只要机器不重启,日志就一直可以查询;一旦重启,内存清空,日志也随之消失。所以在这种模式下,journalctl -b -1 查不到上一次启动的记录。
换句话说,持久化解决的不是”能不能记录”,而是”重启后还在不在”。要让日志跨重启保留,就要启用持久化存储,把记录写到磁盘上的 /var/log/journal。
采用哪种存储方式,由 journald 配置中的 Storage= 参数决定。它有四个可选值,对应的保存位置和行为如下表:
| 设置 | 行为 |
|---|---|
volatile |
易失存储,保存到 /run/log/journal |
persistent |
优先保存到 /var/log/journal;启动早期或磁盘不可写时,暂存到 /run/log/journal |
auto |
默认值。/var/log/journal 存在时持久化,否则使用易失存储 |
none |
不保存 journal 记录,但向 syslog、控制台等的转发仍可能继续 |
journald 的配置由主配置文件和配置片段两部分组成。
主配置文件是 /etc/systemd/journald.conf,文件里被注释掉的各行就是默认值。
配置片段是放在 /etc/systemd/journald.conf.d/ 等目录下、以 .conf 结尾的文件,会覆盖主配置文件中的同名参数;多个片段按文件名顺序读取,后读取的生效。
发行版和软件包有时会在 /usr/lib/systemd/journald.conf.d/ 下放入自己的片段,所以只看主配置文件,未必能看到真正生效的值。
要查看全部配置,可以用下面的命令。它会按读取顺序依次列出主配置文件和所有配置片段的内容:
1 | systemd-analyze cat-config systemd/journald.conf |
配置写对了,不等于已经生效。修改后需要重启 journald,并确认 journal 文件实际写在哪里:
1 | journalctl --header | grep -i "file path" |
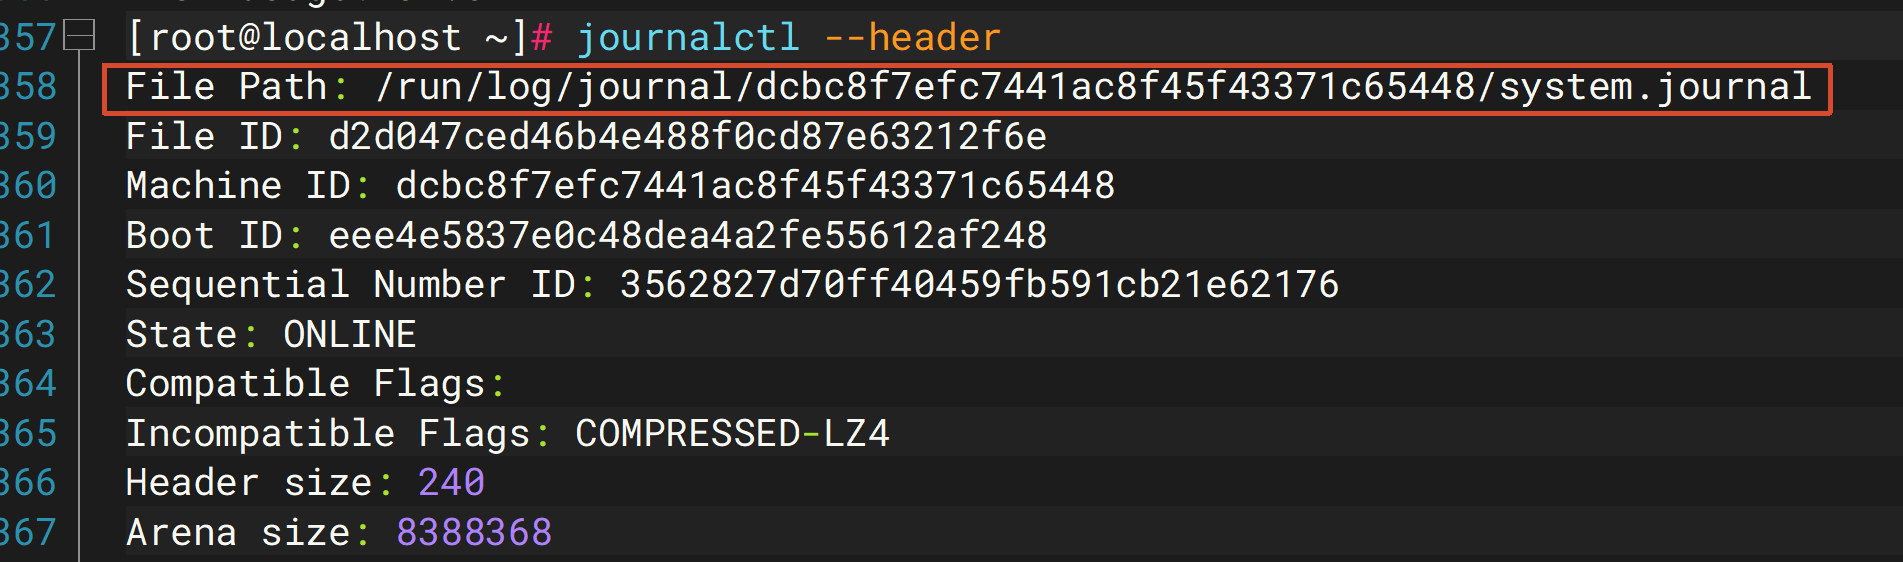
路径在 /run/log/journal 下,说明当前是易失存储;在 /var/log/journal 下,说明已经持久化。
发行版和安装镜像都可能修改默认配置。要判断一台麒麟、统信、RHEL 或 Debian 系机器是否已经持久化,要看两件事:实际生效的配置,以及 /var/log/journal 里是否真的有记录。只凭发行版家族判断,或者只看目录在不在,都可能出错。
推荐用配置片段的方式修改 journald 配置,明确指定持久化:
1 | sudo mkdir -p /etc/systemd/journald.conf.d |
生产环境中,建议把容量限制和持久化写在同一个片段里。上面的数值仅为示例,具体取值方法见本章第 4 节。
然后重启 journald,再刷新一次:
1 | sudo systemctl restart systemd-journald |
这里一定要用 restart,不要拆成 stop 和 start 两步。按 systemd 文档的说明,restart 会保留各服务连到 journald 的日志流;单独执行 stop 则会断开这些连接,之后这些服务的标准输出就不再进入 journal。
配置完成后,先确认关键服务的新记录仍在正常进入 journal;等下一次计划内重启后,再确认重启前的记录可以查到。持久化只对此后的记录生效,已经随重启消失的记录无法找回。
4. 限流、容量与清理
开启持久化之后,journald 仍然会限制写入速率和磁盘占用。这两项限制都可能让你以为日志都在,其实少了一部分。
限流由 RateLimitIntervalSec= 和 RateLimitBurst= 控制。较新版本 systemd 的默认值如下;早期版本的 RateLimitBurst 是 1000,具体以本机的 man journald.conf 为准:
1 | RateLimitIntervalSec=30s |
限流按服务分别计算,实际阈值还会随可用磁盘空间自动调整。日志中出现 Suppressed N messages 时,说明有 N 条消息被丢弃了,手里的记录并不完整。如果某个服务确实需要高频输出,可以在它的 unit 文件里用 LogRateLimitIntervalSec=、LogRateLimitBurst= 单独放宽(systemd 240 起支持),不要直接取消全局限流。
容量方面,持久化 journal 由两个参数控制:SystemMaxUse= 规定最多占用多少空间,SystemKeepFree= 规定至少给磁盘留出多少空闲。例如红帽为 OpenShift 集群节点给出的 journald 示例配置是:
1 | SystemMaxUse=8G |
数值仅为示例。实际取值可按”日均日志量 × 本机保留天数 × 1.5”估算,日均日志量可以用 journalctl --disk-usage 除以已记录的天数粗略得出。
易失存储有一组对应的 Runtime* 参数。
journald 按容量删除旧文件,所以日志能保留多少天并不固定:日志量越大,同样的空间能覆盖的时间就越短。MaxRetentionSec= 可以按时间删除旧记录,但它设定的是保留时间的上限,并不能保证最短保留多久。
查看当前占用:
1 | journalctl --disk-usage |
需要手工清理时,可以按空间或按时间清理:
1 | sudo journalctl --vacuum-size=500M |
vacuum 只清理已归档的 journal 文件,正在写入的活动文件不受影响,所以执行后总占用可能仍高于指定值。如果想先把当前文件归档再一起清理,可以加上 --rotate。清理之前,记得先把故障调查需要的记录导出保存。
四、rsyslog:接收、处理与转发
前一章讲的 journal,解决的是本机日志的收集、保存和查询。
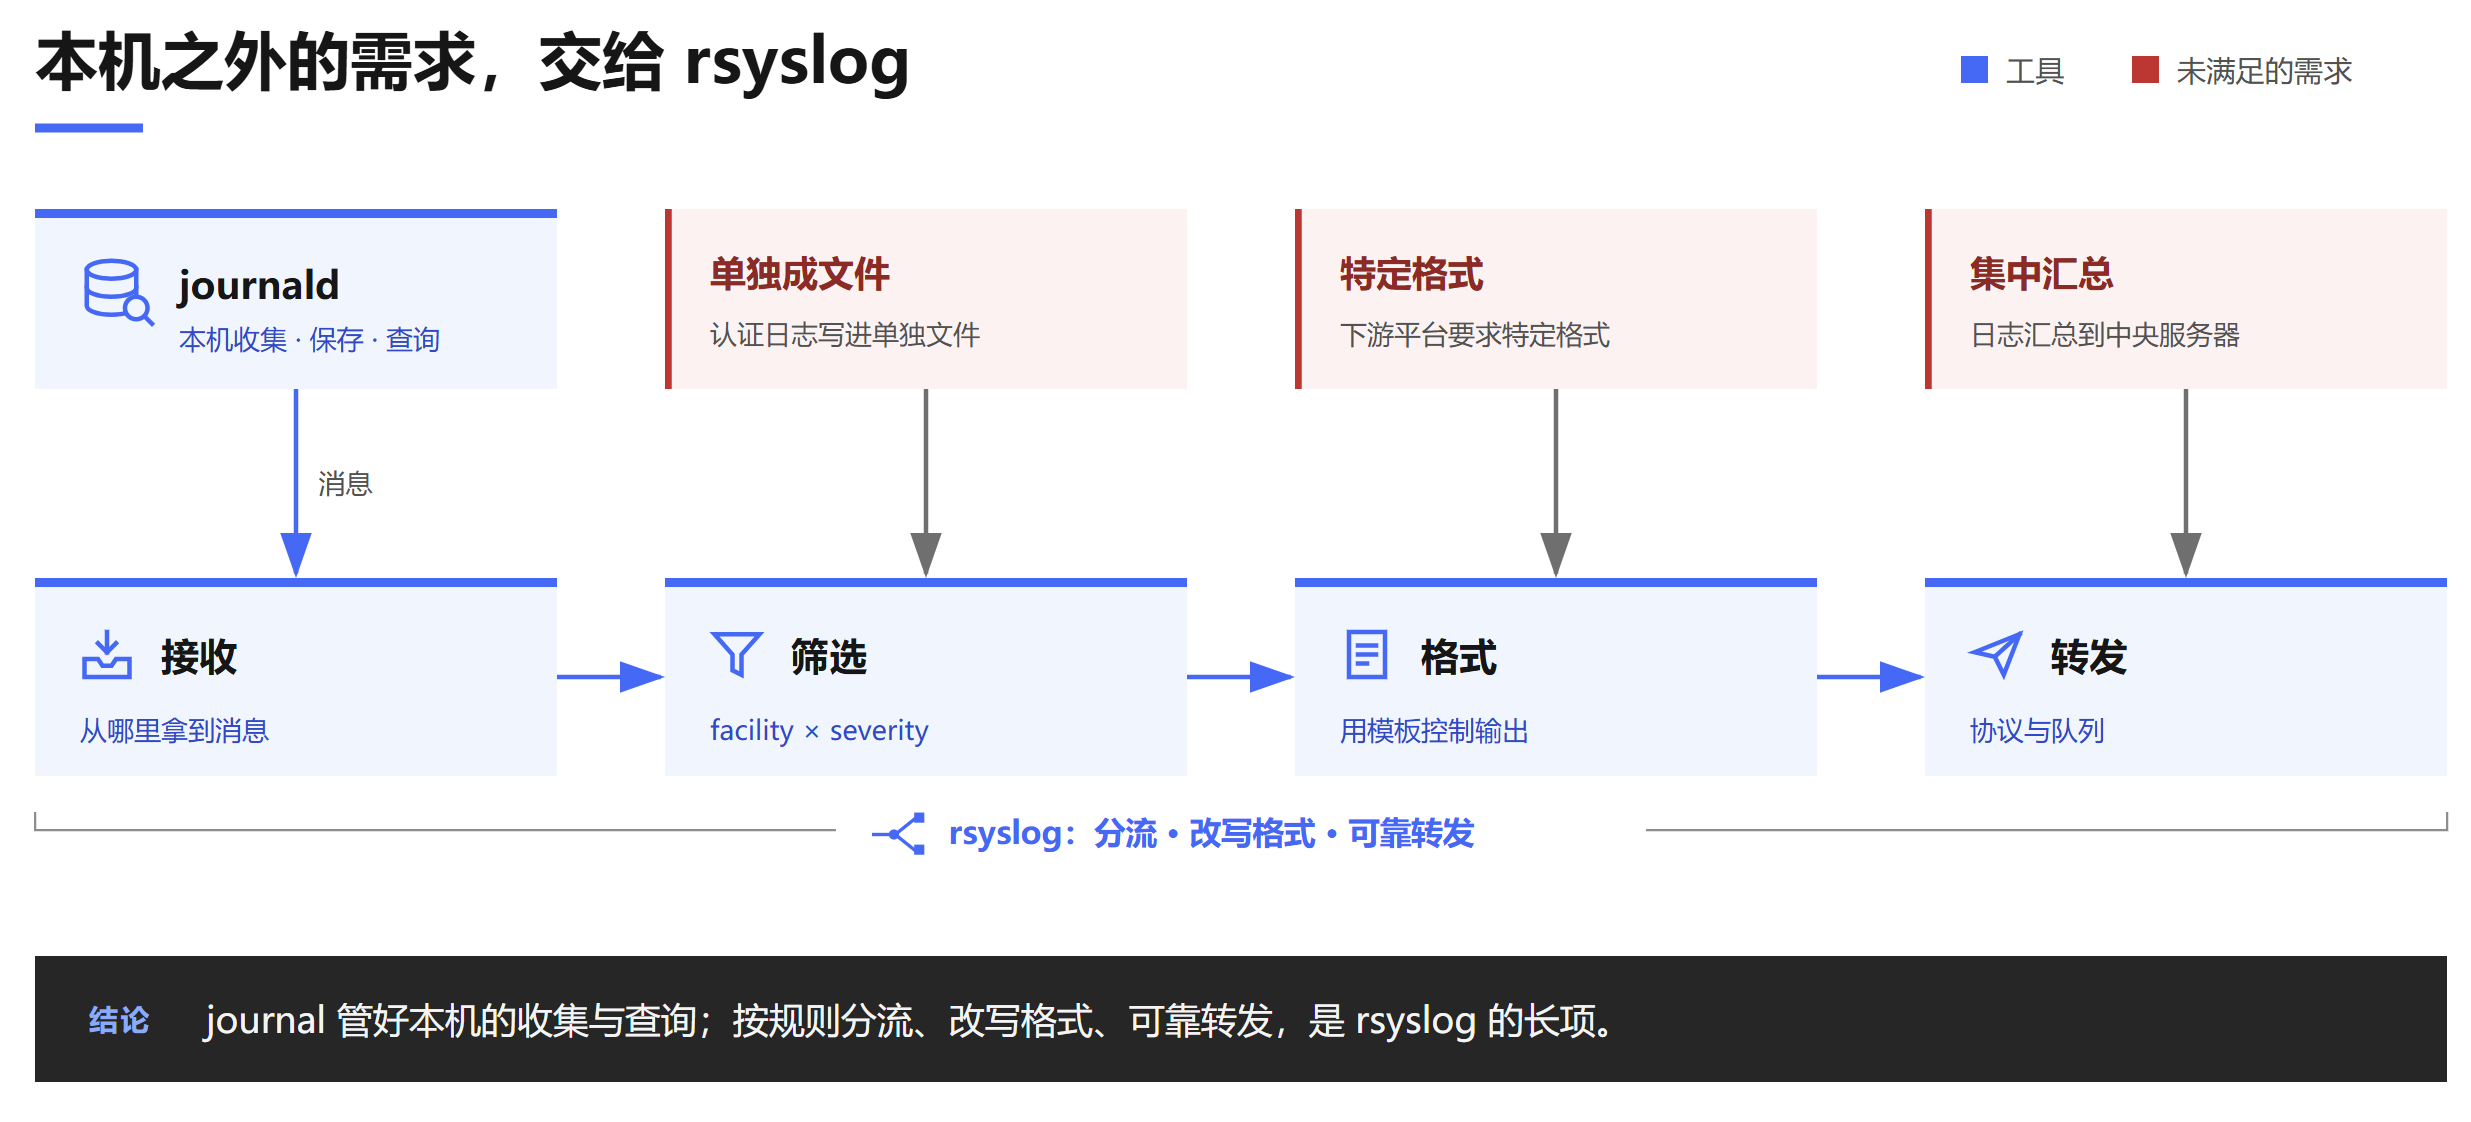
读到这里,你可能会有一个疑问:journal 已经能保存和查询日志,为什么 RHEL 等发行版还要默认运行 rsyslog?反过来,Debian 12 为什么又不再默认安装它?
要回答这个问题,关键是弄清 rsyslog 在什么情况下是必要的。
本章的核心观点是:rsyslog 的价值在于”按需”。
1. rsyslog 的定位变了
在很长一段时间里,rsyslog 是每台 Linux 机器上默认运行的必需组件。原因很简单:它是把日志保存到磁盘上的那个程序。
即使到了 systemd 时代,RHEL 7、8 仍然沿用这种分工。journald 的默认设置是 Storage=auto,只有 /var/log/journal 目录存在时才把日志写到磁盘,而 RHEL 默认没有创建这个目录。于是 journal 只保存在内存里,一重启就没了。真正跨重启保留日志的,仍然是 rsyslog:它从 journal 读取消息,写进 /var/log/messages、/var/log/secure 等文本文件,再由 logrotate 定期轮转。
可以在一台默认安装的 RHEL 8 上验证这一点:
1 | ls -ld /var/log/journal # 目录不存在,说明 journal 没有持久化 |
如果第三条命令能找到多次开机时的内核版本记录,而 --list-boots 只有一行,就说明:重启前的 journal 已经随内存清空,但 rsyslog 写下的文本日志还在。
Debian 12 走了另一条路:默认开启 journal 持久化。journal 自己就能跨重启保存日志,rsyslog 再写一份文本文件,同一份日志就会在磁盘上存两遍。所以 Debian 把 rsyslog 改为可选组件,不再默认安装。
这两种做法对比下来,结论很清楚:rsyslog 在单机上最主要的作用,是在 journal 不持久化时承担持久保存。journal 持久化以后,这个作用就重复了。 rsyslog 的定位也随之变化,从”每台机器都默认运行的必需组件”,变成了”有特定需求时再使用的工具”。
2. 什么时候需要 rsyslog
判断要不要 rsyslog,不看发行版默认装没装,而看有没有下面这些需求。每一种需求,都是 journal 单独解决不了的。
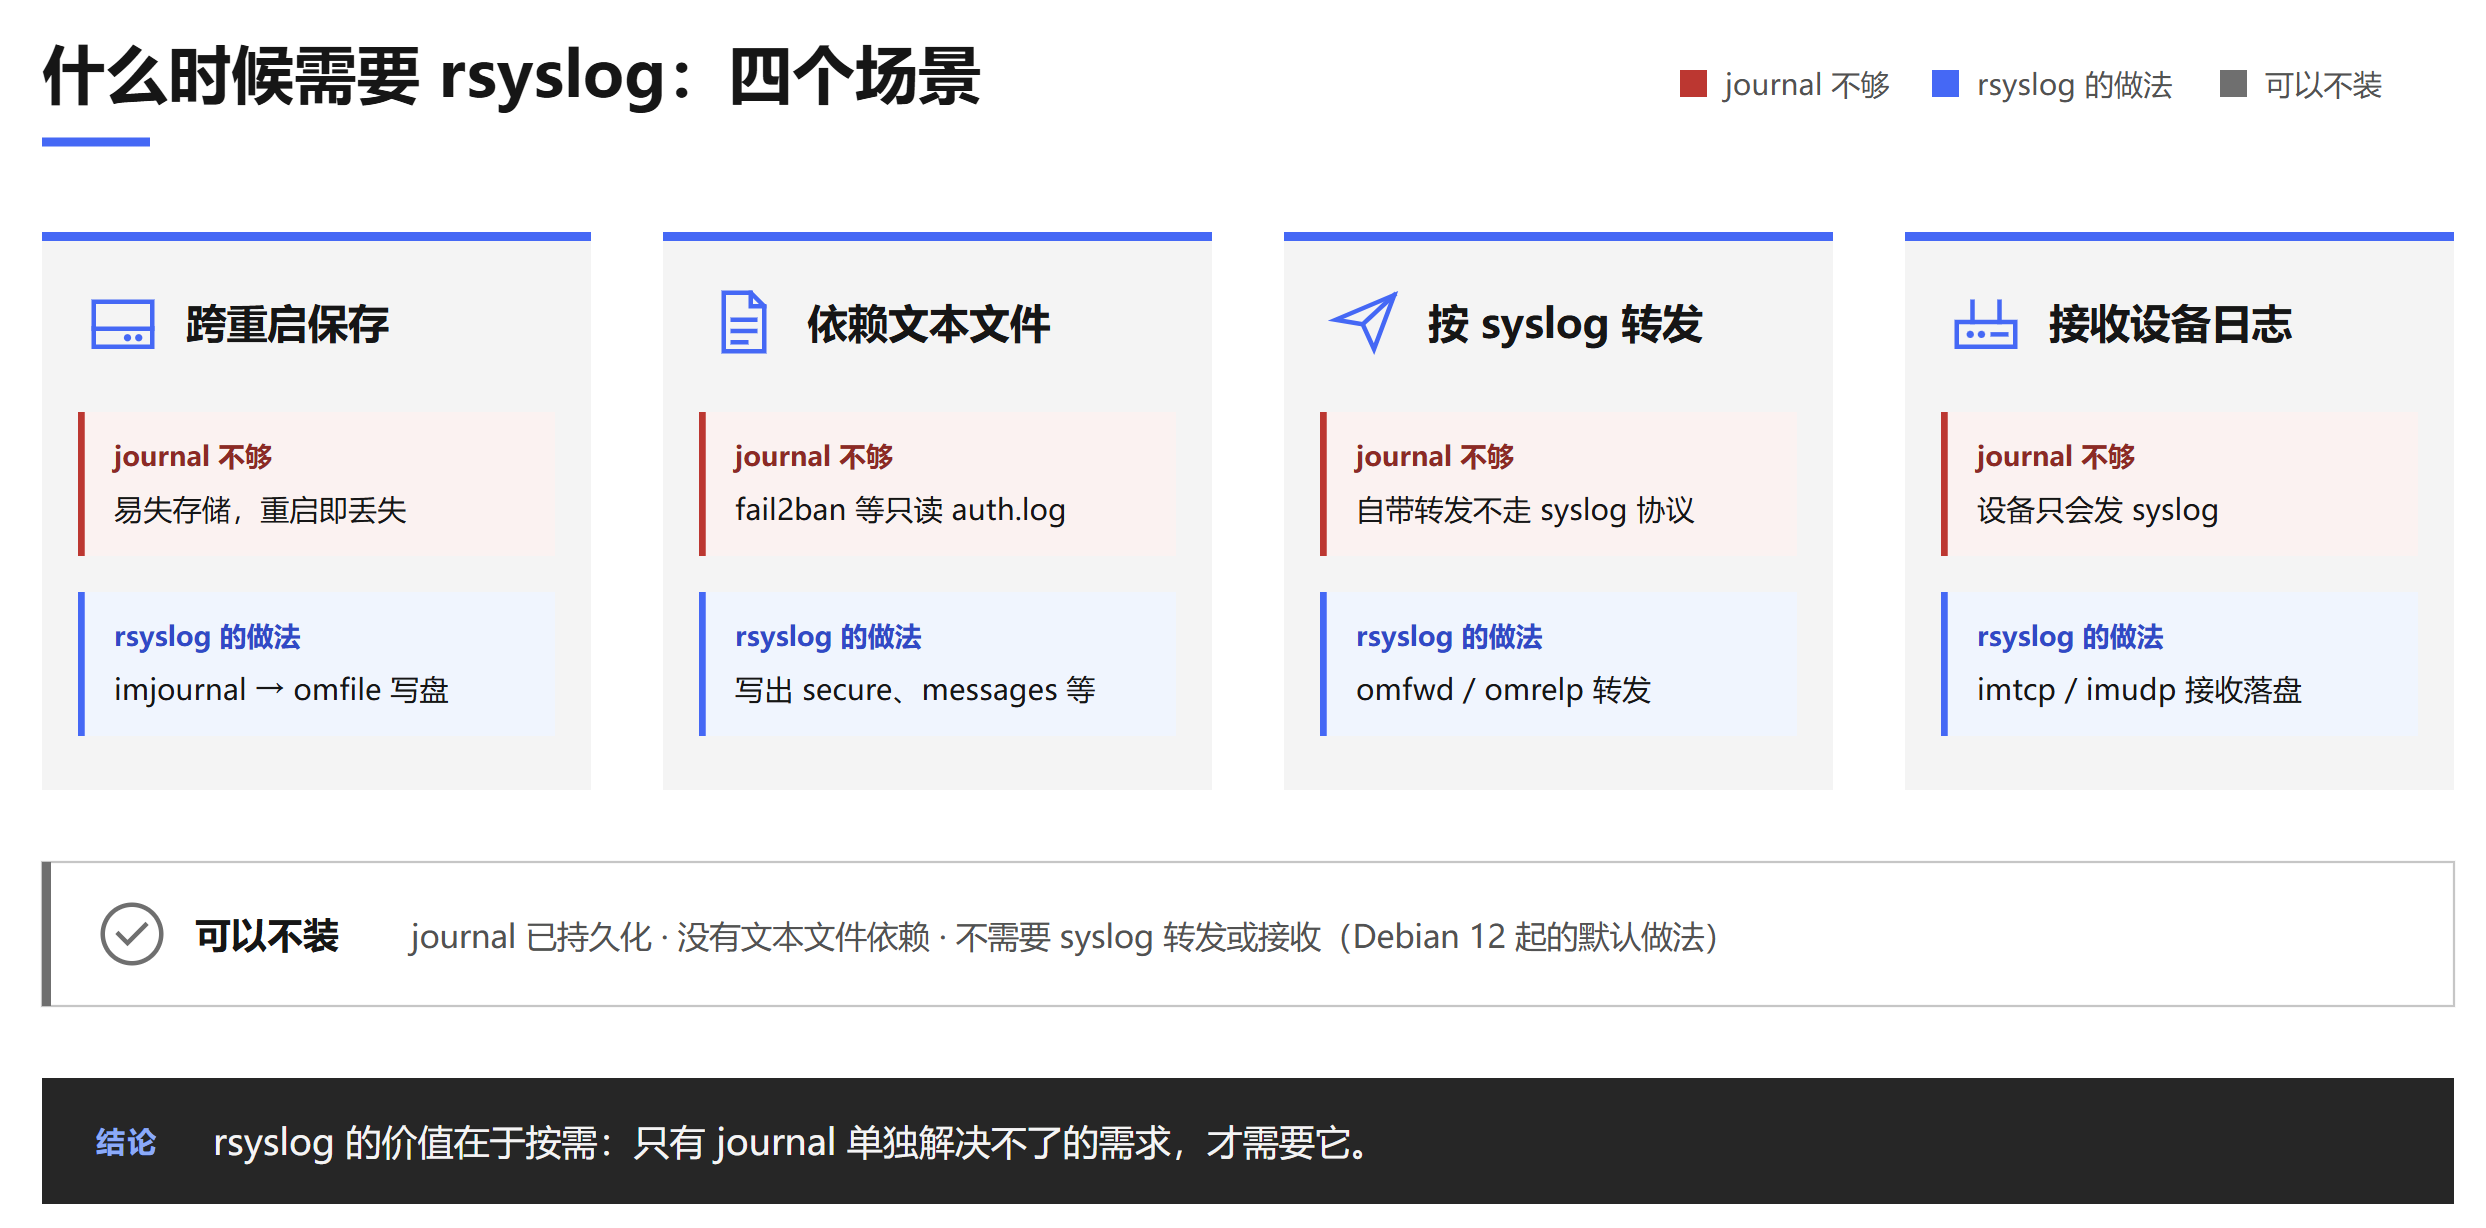
场景一:journal 不持久化,需要日志跨重启保存。
这就是 RHEL 7、8 的默认情况。如果不开 journal 持久化,又停掉 rsyslog,机器一重启,所有日志都会消失。
场景二:工具和规范依赖传统文本文件。
许多监控代理、安全审计工具、运维脚本和检查清单,都默认读取 /var/log/secure、/var/log/auth.log 这样的文件。文本文件用 grep、tail 就能直接查看,不依赖 journalctl;即使 journal 文件损坏,文本日志也不受影响。只要环境里有这类依赖,就需要 rsyslog 生成这些文件。
一个真实的例子是 fail2ban,这是一个通过分析登录日志来封禁暴力破解 IP 的安全工具。Debian 12 不再默认安装 rsyslog 后,fail2ban 默认仍去读取 /var/log/auth.log,而这个文件已经不存在。从旧版本升级上来的系统情况更隐蔽:如果卸载了 rsyslog 却保留了旧文件,文件还在,但不再更新,防护就这样悄无声息地失效了。解决办法有两种:让 fail2ban 改为直接读取 journal,或者重新安装 rsyslog。到了 Debian 13,fail2ban 已默认改为读取 journal。
这个例子说明,去掉 rsyslog 之前,要先确认有没有工具依赖它生成的文件。
场景三:按 syslog 协议把日志送到别处。
需要把日志集中到中央服务器或日志平台时,rsyslog 是现成的转发器:多数 Linux 主机本来就装着它,加一条转发规则即可,不必另装采集代理。journald 自带的 systemd-journal-upload 虽然也能转发,但用的是 systemd 自己的协议,接收端也必须是 systemd 的组件。要对接只认 syslog 协议的服务器或平台,仍然要靠 rsyslog 这类工具。
场景四:接收其他设备发来的日志。
防火墙、交换机、负载均衡器等网络设备,通常只能通过 syslog 协议发送日志。业内常见的做法,是部署专门的 syslog 服务器(rsyslog 或 syslog-ng),先把这些设备的日志稳定地接收、落盘、分类,再交给后端的日志平台。Splunk 等平台也把专用 syslog 服务器作为接收 syslog 的推荐做法,而不是让平台自己直接监听端口。
需要说明的是,rsyslog 能把多台机器的日志收集到一处、按主机分目录保存,但它不提供索引和检索界面。今天主流的集中日志平台,比如 Elasticsearch/OpenSearch、Grafana Loki、Splunk、Graylog,都不是基于 rsyslog 构建的;在容器和云原生环境中,主机上的采集工作也越来越多地交给 Fluent Bit、Vector、OpenTelemetry Collector 这类新一代采集器。rsyslog 在多机环境中的位置,是负责接收和转发的那一层,而不是整个日志平台。
反过来,如果 journal 已经持久化,又没有文本文件依赖,也不需要 syslog 转发或接收,那就可以不装 rsyslog,Debian 12 默认就是这样。
3. 单机上怎么搭配
落到单机上,journal 和 rsyslog 常见的搭配有三种:
| 组合 | 代表 | 优点 | 代价 |
|---|---|---|---|
| journal 易失 + rsyslog 文本持久化 | RHEL 7、8 默认 | 不重复写盘;文本日志兼容性好 | 重启后丢失结构化字段,无法用 -b -1 回看 |
| journal 持久化 + rsyslog | 很多生产环境的选择 | 排障能力最强,兼容性也最好 | 同一份日志存两份,要分别控制容量 |
| 只用持久化 journal | Debian 12 默认 | 结构简单,没有重复存储 | 没有传统文本文件;依赖它们的工具要调整 |
第一种组合的代价值得多说一句:journal 里的可信字段,比如 _PID、_SYSTEMD_UNIT、_BOOT_ID,写进文本文件后大多丢失了,只剩时间、主机名、程序标签和正文。
对于 RHEL 生产服务器,第二种组合往往最稳妥:磁盘成本不高,而意外重启后能用 journalctl -b -1 查看重启前的完整记录,在排查宕机时非常有价值。磁盘紧张、又不需要回看历史启动的机器,保持默认也可以。新部署、没有历史包袱的系统,可以考虑第三种。
想知道自己的机器属于哪一种,看两件事就够了:
1 | systemctl is-active rsyslog # rsyslog 是否在运行 |
4. rsyslog 的工作原理
可以把 rsyslog 想象成一个邮件分拣中心:信件从几个收件口进来,按分拣规则分好类,再从不同的发件口送出去。对应到 rsyslog,流程如下图所示:
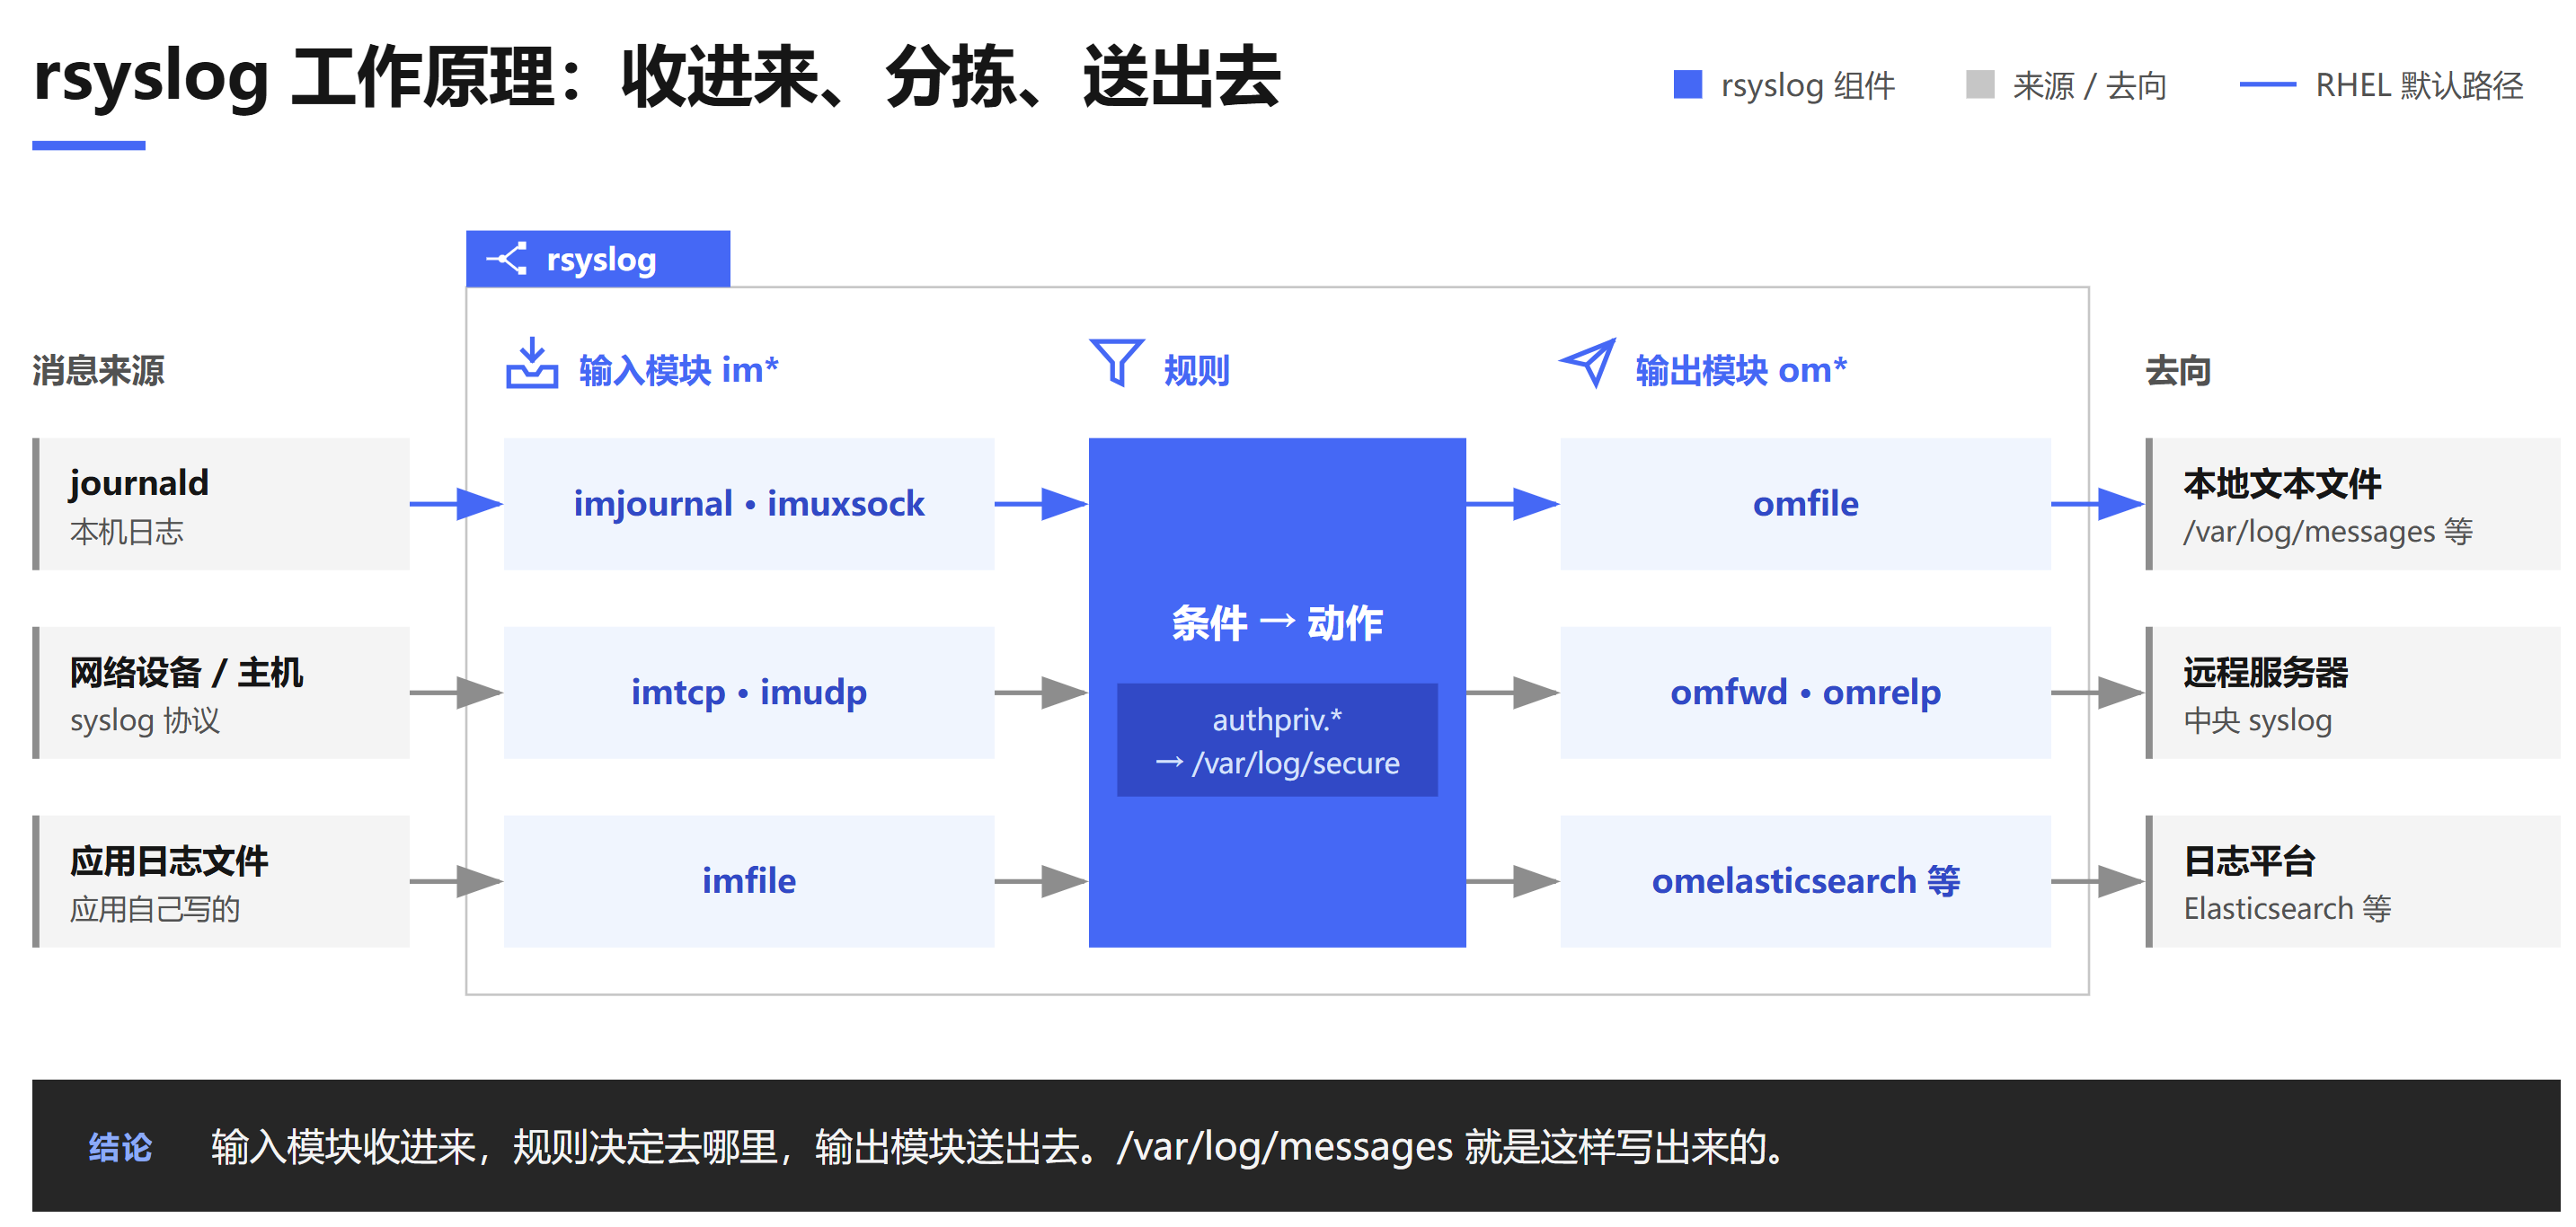
输入模块:消息从哪里来。 相当于分拣中心的收件口,名字以 im(input module)开头。常见的有:
| 模块 | 作用 | 对应场景 |
|---|---|---|
imjournal |
直接从 journal 读取消息,RHEL 7、8 默认使用 | 场景一、二 |
imuxsock |
通过本机的 syslog 套接字接收消息,Debian 系通常用它接收 journald 转发的消息 | 场景一、二 |
imtcp、imudp |
在网络端口上接收其他主机或设备发来的日志 | 场景四 |
imfile |
读取应用自己写的文本日志文件 | 场景三 |
使用 imuxsock 时有个前提:journald 必须开启 ForwardToSyslog=yes,否则 rsyslog 收不到消息,自然也写不出文件。
规则:消息该去哪里。 相当于分拣规则。每条规则由”条件”和”动作”两部分组成,最常见的条件是来源类别和严重级别。例如 RHEL 默认配置中的这一行:
1 | authpriv.* /var/log/secure |
左边的 authpriv.* 是条件,表示认证类消息的所有级别;右边是动作,表示写入 /var/log/secure。一条消息可以同时匹配多条规则,所以它可以既写进本地文件,又转发到远端。
输出模块:消息送到哪里。 相当于分拣中心的发件口,名字以 om(output module)开头。常见的有:
| 模块 | 作用 | 对应场景 |
|---|---|---|
omfile |
写入本地文件 | 场景一、二 |
omfwd |
通过 UDP 或 TCP 转发到另一台主机 | 场景三 |
omrelp |
用 RELP 协议转发,接收端会回复确认,比普通 TCP 更可靠 | 场景三 |
omelasticsearch、omkafka 等 |
把日志直接写入 Elasticsearch、Kafka 等系统 | 场景三、四 |
把三个环节串起来,RHEL 上 /var/log/messages 的来历就清楚了:journald 收集消息,imjournal 把消息读进 rsyslog,规则挑出该写进这个文件的消息,最后由 omfile 写入磁盘。
除此之外,rsyslog 还提供一些进阶功能,比如用模板决定写出的每一行长什么样,用磁盘队列在网络中断时缓存待转发的消息。需要时查阅 rsyslog 官方文档即可。
这些都写在配置文件里。 主配置文件是 /etc/rsyslog.conf,自定义配置一般放在 /etc/rsyslog.d/ 下、以 .conf 结尾的文件中。RHEL 的默认规则大多直接写在 /etc/rsyslog.conf 里,Debian 和 Ubuntu 则放在 /etc/rsyslog.d/50-default.conf 中。
要注意的是,rsyslog 的规则按顺序执行,/etc/rsyslog.d/ 下的文件会按文件名顺序,插入到主配置文件中 include 语句所在的位置。这和 journald 的配置片段”覆盖同名参数”不同:自定义规则放在哪个文件、文件叫什么名字,都可能影响结果。修改配置后,先检查语法,再重启服务:
1 | sudo rsyslogd -N1 |
rsyslog 和各类应用写出的文本文件会不断增长,需要定期轮转和清理,这就是下一章 logrotate 的工作。
五、logrotate:文本日志的轮转
1. 为什么需要 logrotate
journal 的容量由 journald 自己管理,而 /var/log 下的文本日志没有这种机制:它们只会追加,不会自动缩小,旧日志也不会自己消失。放任不管,轻则文件越来越大,查看和排障都很吃力;重则写满磁盘,连累同一分区上的其他服务。logrotate 就是用来解决这个问题的。
logrotate 的做法是”轮转”:定期把当前的日志文件改名归档,换一个新文件继续写;归档的旧文件压缩存放,超过保留份数的就删除。这样,日志始终分成”正在写的一个”和”归档的若干个”,总占用可控,查看也方便。
关于 logrotate,有三点需要先明确:
- 它管所有文本日志,不只是 rsyslog 的。 rsyslog 写的
/var/log/messages,以及 nginx、dnf、apt 等应用自己写的日志,都靠 logrotate 轮转。 - 它不管 journal。 journal 由 journald 按容量参数自行清理(见第三章第 4 节),不要给
/var/log/journal配置 logrotate 规则。 - 它不是常驻服务。 logrotate 在主流发行版中通常默认安装,但它并不在后台持续运行,而是由 systemd timer(
logrotate.timer)或 cron 每天调用一次,执行完就退出。
2. 一次轮转做了什么
logrotate 每次被调用时,大致会经历以下步骤:
- 判断是否需要轮转。 读取配置,再查看自己的状态文件,里面记录着每个日志上一次轮转的时间,据此判断是否满足条件。
- 把当前文件改名归档。 例如
app.log改名为app.log.1,已有的归档依次后移,超过保留份数的最旧一份被删除。 - 新建一个空文件。 用原来的文件名新建
app.log,供程序继续写入。 - 通知应用重新打开日志。 让正在写日志的程序改为写入新文件。
- 压缩归档文件,并更新状态文件。
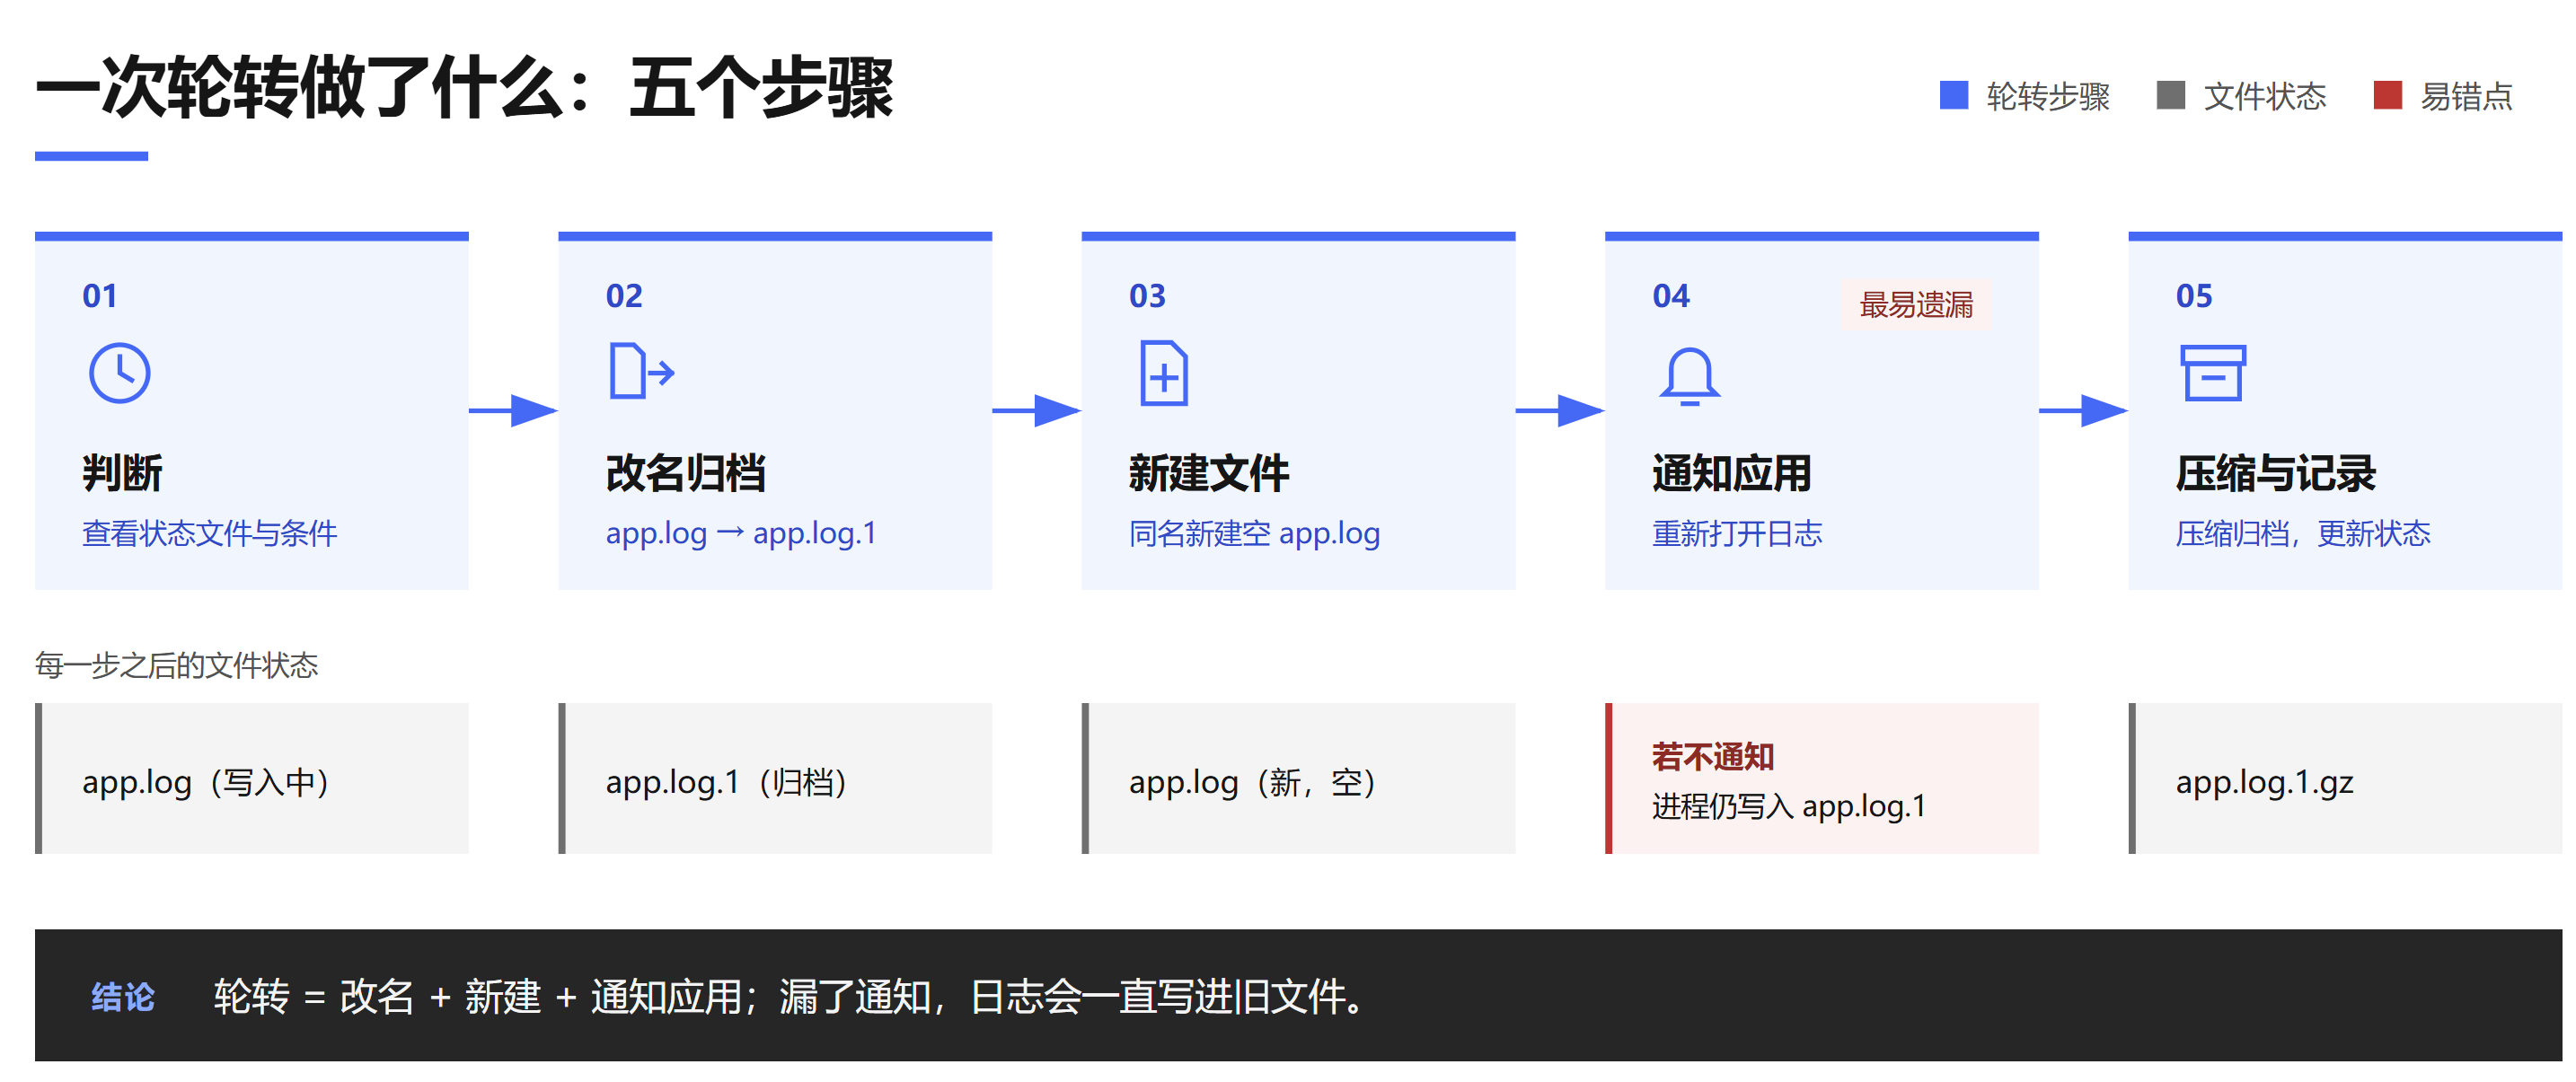
其中第 4 步最容易被忽视,却必不可少。原因在于,进程是通过文件描述符写日志的,描述符指向的是文件的 inode,而不是文件名。轮转只是改了文件名,inode 没变,如果不通知,进程会继续往改名后的 app.log.1 里写,新建的 app.log 一直是空的。同样的道理,删除一个仍被进程打开的日志文件,磁盘空间也不会释放,可以用 sudo lsof +L1 找出这类文件。
所以,轮转后要让应用重新打开日志文件,具体用什么命令或信号,以应用文档为准。例如,RHEL 上 rsyslog 的轮转规则会在轮转后给 rsyslog 发送 HUP 信号。对于不支持重新打开日志的应用,可以改用 copytruncate:先复制一份内容作为归档,再把原文件清空,这样 inode 不变,代价是复制和清空之间写入的内容会丢失。
另外有两个细节:
- 归档文件的命名因发行版而异。 RHEL 默认启用了日期后缀,所以
/var/log下会出现messages-20261004这样的文件;Debian 默认使用数字后缀,比如syslog.1、syslog.2.gz。 - 轮转条件只在 logrotate 被调用时才检查。 因为 logrotate 每天只运行一次,
size 100M的含义是:下次运行时,如果文件超过了 100 MB 就轮转,而不是一涨到 100 MB 就立刻轮转。
3. 一个最简单的配置
logrotate 的全局默认设置在 /etc/logrotate.conf 中,各软件的轮转规则放在 /etc/logrotate.d/ 下,一个软件一个文件。
假设有一个应用 myapp,把日志写在 /var/log/myapp/ 下,并且支持通过 reload 重新打开日志文件。新建 /etc/logrotate.d/myapp,写入:
1 | /var/log/myapp/*.log { |
这几行的意思是:每天检查一次,保留 7 份归档,归档文件压缩存放,日志文件不存在时不报错;轮转完成后执行 systemctl reload myapp,通知应用重新打开日志。
写好后,先用 -d(调试模式)空跑一次。它只显示 logrotate 将要执行的操作,不会真正改动任何文件:
1 | sudo logrotate -d /etc/logrotate.d/myapp |
小结
syslog 最早解决了日志的统一收集和分类;syslog-ng 和 rsyslog 补上了可靠传输和灵活处理;RFC 5424 统一了消息格式;journald 带来了可信的来源信息和按字段查询。这些组件如今大多同时存在于一台机器上,各自承担接收、保存、转发、清理中的一部分。其中,rsyslog 的角色正在从默认必需的组件,变成按需使用的工具。
下次再遇到 /var/log/messages 是空的、journalctl 里却有记录,先别急着找丢失的日志。先看清这台机器的日志实际走了哪条路:谁接收,谁保存,谁转发,谁清理。